

QA テストケースの AI 生成をスキル化し、精度検証から実運用まで行った話
目次
はじめに
ジャンプTOON の Web フロントエンド開発を担当している、細見元気です。
ジャンプTOONの機能開発では、仕様書などの関連資料を基に QA テストケースを作成し、そのテストケースに基づいて、QA エンジニアがリリース前の動作確認を行っています。
QA テストケースを作成するには、対象機能の仕様だけでなく、既存機能への影響や、サービス固有のテスト観点まで理解する必要があります。しかし、判断に必要な情報は Notion・Linear・Slack・Figma・実装コードなどに分散しています。さらに、明文化されていないテスト観点も存在します。そのため、実務水準の QA テストケースを作成するには、複数の情報源から仕様を再構成し、不確定事項を解消し、テスト観点を反映する必要があり、難易度の高い作業です。
これまでは人間がこの作業を担ってきましたが、人手だけで開発速度と品質を両立しながらスケールさせることは現実的ではありません。そこで、AI で QA テストケースを生成するスキルを提案します。
提案手法は、仕様書を入力して QA テストケースを生成するだけではありません。複数のソースを探索し、対話によって不確定な仕様を確定させ、過去の QA テストケースから抽出したテスト観点を生成へ反映します。
本記事では、提案手法の設計、過去の QA を用いた比較実験による精度検証、そして実運用へつなげるまでの過程を紹介します。
結論 — 実験結果
生成した QA テストケースが、人手で作成され、過去に運用されていた QA テストケースをどれだけ再現できたかを 再現率 で評価しました。
主な実験結果
| 指標 | 仕様書のみ | +Slack 等 | +コード | +対話で仕様確定 | +テスト観点 提案手法(全要素を適用) |
|---|---|---|---|---|---|
| 再現率 | 31.9 % | 37.1 % | 37.5 % | 47.9 % | 69.2 % |
- 仕様書のみと比べて、対話による仕様確定と抽出したテスト観点を活用した提案手法は再現率が +37.3 %(約 2.2 倍)向上しました。
- この 69.2 % という数値は、これまで人手で運用してきた QA テストケースのうち、約 7 割を AI が生成できるようになったことを意味します。
- 以上のような定量評価に加え、試験運用による定性評価を行った上で、現在は実運用への移行をしています。
詳細な実験条件と結果は 「4. 実験」で説明します。
前提 — QA とは
QA (Quality Assurance/品質保証)とは、開発した機能が、ユーザーの期待する品質を満たし、安全にリリースできる状態かを判断するプロセスです。
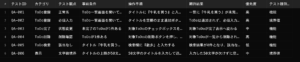
本記事では、その中でも QA テストケースの作成に焦点を当てます。QA テストケースは、「どの条件で」「何を操作し」「どこを確認し」「どうなれば合格か」を記述したものです。本記事では、QA テストケースの AI 生成を検証し、その品質を向上させる手法を提案します。
↓ QA テストケースの例
なぜ QA テストケース作成に AI を活用する必要があるのか
QA テストケースの作成には、仕様の理解だけでなく、サービス全体の理解、影響範囲の把握などが必要であり、難易度の高い作業です。これまでは人間が担ってきましたが、リリースや仕様変更が増えるほど確認すべき条件も増えるため、人手だけで開発速度と品質を両立しながら QA テストケース作成をスケールさせることは困難です。
生成 AI なら、仕様書・チャット・デザイン・コードなどを読み合わせ、QA テストケース作成を支援できます。実際、テストケース作成は生成 AI の主要な用途になっています。(World Quality Report 2025)。
なぜ QA テストケースの AI 生成は難しいのか
先にも述べた通り、QA テストケースの作成には、仕様とサービス全体を理解し、影響範囲を見極める必要があります。しかし、仕様は Notion や Slack や Git など複数の関連資料に分散し、関連資料間で矛盾が発生する場合もあります。さらに、明文化されていないテスト観点を扱う必要があります。QA テストケースを AI で生成するには、このような課題を解決する必要があります。詳細を 「1. 課題」で説明します。
1. 課題
実務水準の QA テストケースを作成するために解決するべき課題を説明します。
1-1. 複数のソースを突き合わせても期待動作が一意に定まらない
実務においては、QA テストケースの作成に必要な情報が複数のソースに分かれて存在しています。
| ソース | 性質 |
|---|---|
| 仕様書 | 既存の共通機能は省略され、参照リンクで他ページへ委譲される |
| 企画書 | 目的や要件など、仕様の背景となる情報が含まれる |
| チャット | 仕様書に反映されない、メンバー間の合意事項が含まれる |
| デザイン | 仕様書に反映されない、UI の決定事項が含まれる |
| 実装コード | 仕様書に基づいた具体的な変更差分が含まれる |
さらに時系列も揃っていません。仕様書や企画書は開発中に追記・改訂され、Slack での議論も並行して更新されます。
つまり、複数のソースを横断し、参照関係と時系列を踏まえて情報を突き合わせる必要があるのです。
しかし、関連するソースをすべて突き合わせても、記載漏れやソース間の矛盾によって、期待動作を一意に定められない箇所が残ることがあります。これを推測で補うと、根拠のない期待動作が QA テストケースに混入してしまいます。
1-2. 明文化されていないテスト観点が必要になる
人手の QA テストケースには、仕様書や関連資料に書かれていない観点が含まれます。チームが過去の QA テストケースや障害対応を通じて蓄積してきた、QA エンジニアの頭の中にしかないプロジェクト固有のテスト観点です。
仕様情報だけを入力にすると、これらの観点を落としてしまいます。そのため、実務水準の QA テストケースを作るには、仕様を読むだけでなく、明文化されていないテスト観点を把握する必要があります。
1-3. 多種多様で複雑な情報を扱うには高いモデル能力が求められる
QA テストケースの AI 生成では、仕様書・企画書・チャット・デザイン・実装コード・過去の QA テストケース・抽出したテスト観点など、形式や役割の異なる情報を同時に扱う必要があります。複数のソースとその参照先を横断し、時系列を踏まえて内容を突き合わせ、矛盾や不確定事項を検出しなければなりません。
さらに、得られた仕様とテスト観点を数百行の QA テストケースへ展開し、条件の網羅性や文言の一貫性を最後まで維持する必要があります。
コンテキストの保持力や推論力が不足すると、参照先やテスト観点の見落とし、矛盾の見逃し、条件展開の欠落につながります。そのため、テスト観点を含む多種多様で複雑な情報を処理できるモデルの能力そのものが、QA テストケースの品質を左右します。
2. アプローチ
1-1 と 1-2 と 1-3 の課題に対し、本手法は次の 3 点からアプローチを行います。
- 仕様の質を高める(課題 1-1 / アプローチ 2-1)
- テスト観点を抽出して利用する(課題 1-2 / アプローチ 2-2)
- Opus 5 の採用(課題 1-3 / アプローチ 2-3)
2-1. 仕様の質を高める
テストケースの品質は仕様の質に左右されるため、仕様の質を高めることが最優先の課題です。本手法は次の 2 点で仕様の質を高めます。
① 分散した情報を横断的に活用する
仕様書だけでなく、企画書・チャット・デザイン・実装コードなど複数のソースを横断的に読み合わせ、参照関係と時系列を踏まえて仕様を補完します(詳細は「3-2. 入力」)。
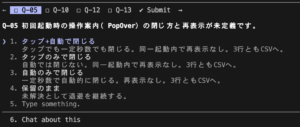
② 対話形式で、曖昧な部分・矛盾した部分を解決する
①を行っても、記載漏れやソース間の矛盾によって期待動作を一意に定められない箇所が残ることがあります。そこで、不確定な項目は要確認事項として次の情報を添えてユーザーへ返します。
- 確認事項 — 何が確定していないのか
- 判断できない理由 — どの情報が不足しているか、またはどの入力が食い違っているか
回答を得てから、該当する QA テストケースへ反映します。
2-2. 過去の QA テストケースと仕様のペアからテスト観点を抽出する
テスト観点の抽出は、本手法の運用開始時に一度だけ行う事前工程であり、案件ごとの QA テストケース生成とは独立しています。導入時に、過去の QA テストケースと、それぞれに対応する仕様書等の入力を比較し、テスト観点を抽出します。
本手法では、明文化されておらず、暗黙知となっているテスト観点を抽出します。
抽出条件は、次の 3 つです。
- QA テストケースに含まれるが仕様書のどこにも書かれていない
- 複数案件で再現する
- 他の案件と矛盾しない
条件を満たすテスト観点は 提案手法 の内部に保存し、その後の QA テストケース生成で共通のテスト観点として継続的に利用します。QA テストケースを作成するたびに抽出をやり直す必要はなく、導入時の最初の一度だけ実行すれば十分です。
2-3. Opus 5 の採用
テスト観点を含む複雑な入力から QA テストケースを作成するために、モデルへ要求される能力を 4 つに分解します。
| 要求される能力 | 詳細説明 |
|---|---|
| 長いコンテキストの同時保持 | 仕様書とその参照先、チャットの履歴、実装コード、過去案件の QA テストケースを横断して突合する必要があります |
| 自律的な探索 | どの関連ページを辿り、どのコンポーネントを読むかを事前に列挙できません。必要な値が参照リンクの先にあるため、モデル自身がツールを使って辿る必要があります |
| 矛盾の検出と判断力 | 複数のソースが食い違ったとき、片方を選ばず「両方を記録して保留する」と判断します。指示への追従だけでは足りず、食い違いに気づける判断力が必要です |
| 長い出力にわたる一貫性 | 数百行にわたって条件軸を対象の全数に掛け、空欄継承・文言の型・重要度の付与を崩しません |
後半 2 つは推論の質に依存します。加えて本タスクの失敗コストは非対称であり、取りこぼしはリリース後の不具合として現れます。したがって推論品質に計算コストを払う価値があると判断し、利用可能な最上位モデルである Opus 5 を採用しました。
3. 提案手法
前提となる開発環境
僕が所属している部署では、開発に必要な情報を次のツールや形式で管理しています。仕様の詳細は 1 か所に集約されておらず、タスク、ドキュメント、会話、デザイン、コード、過去の QA テストケースへ分散しています。提案手法は、これらを必要に応じて横断することを前提に設計しています。
| 情報 | 管理・参照先 | 主な内容 |
|---|---|---|
| タスク・要件 | Linear | 開発タスク、目的、スコープ、受入条件 |
| 仕様書・関連ドキュメント | Notion | 期待動作、関連機能、参照先の仕様 |
| 議論・決定事項 | Slack | 仕様書へ未反映の合意、確認結果、変更内容 |
| UI デザイン | Figma | 画面要素、表示状態、文言、操作フロー |
| 実装 | Git リポジトリ | 変更差分、入力制約、表示書式、既存機能との関係 |
| 過去の QA テストケース | Spreadsheet | テスト観点の抽出元、観点の粒度、文言の型 |
全体構成
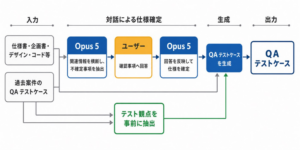
3-1. テスト観点を事前に抽出
テスト観点の抽出は、過去案件の QA テストケースを用いて最初の一度だけ実行して保持します。なお、テスト観点の抽出は以下に従います。
3-2. 入力
仕様書を必須入力とし、期待動作の根拠は仕様書に限定します。その他の情報は、仕様を読み解き、漏れなく展開し、書き方を揃えるための補助入力として利用します。
| 入力 | 用途 |
|---|---|
| 仕様書(Notion) | QA テストケースの観点の根拠です。本文から辿れる子ページや関連仕様、データベースも、対象機能に関係する範囲で読みます |
| 企画書 / Linear / Slack | 目的・重要度・スコープの判断、受入条件の補完、仕様書にない決定や解釈の確認 |
| Figma | UI 要素と、通常・ローディング・空・エラーなどの状態の把握 |
| Git | Git リポジトリの URL です。仕様が名指しした画面・項目の入力制約や表示書式を具体化します |
| テスト観点 | 過去案件から抽出した、プロジェクト固有の観点や行の展開規則 |
| 過去案件の QA テストケース | 大項目の切り方、条件展開の粒度、観点の並べ方、文言の型を揃える |
3-3. 上記入力から QA テストケースの作成を Opus 5 に指示する
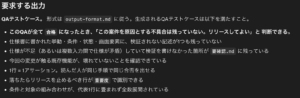
指示は、Opus 5 の自律性と推論力を引き出すことを重視して設計しています。(Claude 5 世代のベストプラクティス )
まず、QA テストケースを作成する具体的な手順は与えません。入力についても、モデルが必要な情報を自由に取捨選択できるようにしています。
一方で、生成物が満たすべき理想的な状態、出力フォーマット、最低限の禁止事項は定めています。ゴールへ到達するためのレールだけを敷き、そこへ至るまでの過程はモデルに委ねる設計です。
3-4. 対話で仕様を確定
入力だけでは期待動作を一意に定められない場合、モデルは推測で補完せず、確認事項として切り出します。回答を得たら、確認結果を QA テストケースへ反映します。
3-5. 出力
| ファイル | 内容 |
|---|---|
| QA テストケース.csv | プラットフォームごとに生成される QA テストケース |
4. 実験
本章では、提案手法の有効性を検証するため、2 つの比較実験を行います。過去に人手で作成され、実際に運用されていた QA テストケースを正例とし、生成した QA テストケースの品質を再現率・適合率・F1 スコアで評価します。主指標は再現率です。
4-1. 実験の目的
提案手法を構成する以下の 3 つの要素が、QA テストケースの品質向上にどの程度寄与するかを定量的に評価します。
- 対話による仕様確定が品質を上げる
- テスト観点の抽出が品質を上げる
- Opus 5 の採用が品質を上げる
4-2. 評価フロー
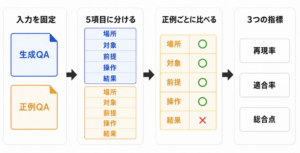
同一 PF(プラットフォーム) の生成した QA テストケースと正例 QA テストケースを 5 項目に分けて照合し、再現率・適合率・F1 スコアを計算します。主指標は再現率とします。
1. 正例と生成を独立して 5 項目に分解する
正例 QA テストケースと生成した QA テストケースは、互いの内容を見せずに別々のサブエージェントが次の 5 項目へ分解します。
| 項目 | 意味 |
|---|---|
| 場所 | 結果を確認する画面・機能・掲載面 |
| 対象 | 検証対象の画面要素・機能・データ |
| 前提 | 成否を変える状態・ロール・データ条件 |
| 操作 | ユーザー操作または発生する事象 |
| 結果 | 期待される振る舞い |
※ 成否を変える前提がない場合だけ「前提」を —、結果自体が確認場所で別の確認先がない場合だけ「場所」を — とします。
2. 正例 QA テストケースが生成 QA テストケースで再現されたかを 5 項目で判定する
正例 QA テストケースを 1 件ずつ基準にし、同じ確認内容に対応する生成 QA テストケースを探します。対応付けた後、正例 QA テストケースの「場所・対象・前提・操作・結果」を生成 QA テストケースと一つずつ比較し、次の記号を付けます。
○— 同じ意味の内容が含まれている×— 内容が不足している、または正例 QA テストケースと異なる—— その項目を QA テストケースに記載する必要がありません。
5 項目すべてが ○ または — なら、その正例 QA テストケースは AI によって再現されたと判定します。
↓ 正例を再現できなかった例
| 項目 | 正例 QA テストケース | 生成した QA テストケース | 判定 |
|---|---|---|---|
| 場所 | 作品詳細 | 作品詳細 | ○ |
| 対象 | コメントボタン | コメントボタン | ○ |
| 前提 | 未ログイン | ログイン | × |
| 操作 | 押す | タップする | ○ |
| 結果 | ログイン案内が表示される | ログイン誘導が表示される | ○ |
例外 1. 項目をまたいでも一致とします
正例項目と同じ意味が、生成した QA テストケースの別項目に明示されている場合は ○ とします。同じ列に書かれていることは必須ではありません。
| 正例の項目 | 生成側の記載 | 判定 |
|---|---|---|
| 前提: 未ログイン | 操作: 未ログイン状態でコメントボタンを押す | ○ — 操作欄に前提の意味がある |
| 対象: コメントボタン | 結果: コメントボタン押下後にログイン案内が出る | ○ — 結果欄に対象の意味がある |
例外 2. 表記揺れ・言い換えを認めます
表現が違っても意味が同じなら ○ とします。条件を変えない具体化や、正例を含意する成功結果も認めます。
| 正例 | 生成 | 判定 |
|---|---|---|
| 押す | タップする | ○ — 操作の表記揺れ |
| 未ログイン | ログアウト状態 | ○ — 同じ状態を指す |
| エラーが表示されない | 保存が完了する | ○ — 同じ条件で、成功結果が正例を含意する |
例外 3. QA テストケースの粒度差は合算できます
- 正例 1 件を生成側が複数件に分けた場合は、必要な生成 QA テストケースを合算して 5 項目を判定します
- 生成 1 件に複数の正例が含まれる場合は、最も具体的に一致する正例 1 件だけへ対応させます
- 同じ生成 QA テストケースを複数の正例へ使い回すことは原則禁止です
例外 4. 正例の — は一致(○)として扱います
正例 QA テストケースの項目が — の場合、その項目はテスト内容を成立させるための記載が不要であることを意味します。そのため、生成 QA テストケースに対応する記載がなくても不一致とはせず、集計では ○ と同じ扱いにします。
3. 指標を計算します
- 再現率: (5 項目すべてが
○の正例 QA テストケース数) ÷ (正例 QA テストケースの数) - 適合率: (正例と一致した生成 QA テストケース数) ÷ (生成した QA テストケースの数)
- F1 スコア: (2 × 再現率 × 適合率) ÷(再現率 + 適合率)
4-3. 対象案件
4 案件 / 7 ファイル / 合計 741 QA テストケース行
| 案件 | ファイル | 行数 | 規模 |
|---|---|---|---|
| A | ユーザー面 + 管理画面 | 35 + 221 | 大きい |
| B | ユーザー面 + 管理画面 | 105 + 116 | 大きい |
| C | ユーザー面 + 管理画面 | 40 + 125 | 小さい |
| D | ユーザー面 | 99 | 小さい |
このほか、正例 QA テストケースがユーザー面 348 件・管理画面 940 件と、他の案件(35~221 件)の 4 倍以上ある案件(以下、案件 E)も実験対象としました。大規模入力における限界として 「4-9. 追加実験」 で別途扱います。
4-4. 実験の詳細
全体設計
第 2 章「アプローチ」で提案した次の 3 点が、QA テストケースの品質向上にどの程度寄与するかを、2 つの比較実験で評価します。
- 対話による仕様確定
- 抽出したテスト観点の活用
- Opus 5 の採用
3 点の効果を切り分けるため、コンテキスト比較の実験①とモデル比較の実験②を実施します。
| 実験 | 評価対象のアプローチ | 比較する条件 |
|---|---|---|
| ① コンテキスト比較 | 1. 対話による仕様確定 2. 抽出したテスト観点の活用 |
同じ条件で、コンテキストを変化 仕様書のみ → +補助情報 → +コード → +対話による仕様確定 → +テスト観点 |
| ② モデル比較 | 3. Opus 5 の採用 | 同じ条件で Opus 5 ↔ GPT-5.6-sol |
実験①: コンテキスト設計の比較
| 項目 | 内容 |
|---|---|
| 目的 | 仕様書以外の情報を段階的に追加したとき、どの情報が QA テストケースの品質の向上に寄与するかを確認します。 |
| 仮説 | 補助情報・コード・対話による仕様確定・テスト観点を累積すると、再現率が段階的に向上すると仮定します。 |
| 変更する条件 | コンテキストを、仕様書のみから「テスト観点・抽出用の過去の QA テストケース」まで累積 5 段階で追加します。 |
| 固定する条件 | モデル: Opus 5 (effort: max) プロンプト: 最低限のみ |
| 実施方法 | 同じ案件・PF に対して、コンテキストだけを変えて生成と評価を実行します。 |
| 評価指標 | 再現率、適合率、総合点(F1 スコア) |
比較する 5 段階
| 段階 | 含める情報 | 確認したい効果 |
|---|---|---|
| 1 | 仕様書のみ | 補助情報なしの基準値 |
| 2 | +企画書・Slack・デザイン | スコープ・UI 状態・受入条件の理解が深まるか |
| 3 | +コード | 仕様が示した画面・要素の具体化により漏れが減るか |
| 4 | +対話で仕様確定 | 仕様の曖昧点を解消すると、正しい QA テストケースが増えるか |
| 5 | +テスト観点(提案手法) | 過去の QA テストケースから抽出した共通のテスト観点で、正しい QA テストケースが増えるか |
その他 共通ルール
- Opus 5 で生成する場合は、effort: max に固定します
- 評価には、Opus 5 を使わず、GPT-5.6-sol の effort: xhigh を用います。これは、自モデルへの優遇を防ぐためです。
- 正例 QA テストケースは評価フェーズでのみ使用し、QA テストケースの生成時には渡しません
- ローカルデータは許可リスト方式で制限します。各実験条件で明示した入力ファイル・フォルダだけを使用し、ローカルフォルダ内のその他のデータは読みません・検索しません・推論に使いません
- 使用しないコンテキストもルールベースで除外します。その条件に含まれない仕様書以外の資料、Slack、デザイン、チケット、コード、対話による仕様確定、テスト観点、過去の QA テストケースは参照しません
- 評価フェーズでは、生成した QA テストケース・同一 PF の正例 QA テストケース・評価基準だけを使用し、仕様書やローカルの補助データを追加参照しません
- 条件ごとに新しく生成し、別条件の生成 QA テストケースを流用・修正しません
- 実験対象の案件は、テスト観点の抽出対象から除外します。 対象 5 案件・9 PF の正例 QA テストケースは、テスト観点の抽出元にも抽出用の過去の QA テストケースにも含めません
- テスト観点とは、実験対象を除く過去の QA テストケースから抽出した、案件横断で再利用できる共通のテスト観点を指します
- 段階 5 では、テスト観点だけでなく、テスト観点の抽出元として抽出に用いた過去の QA テストケースもコンテキストへ同梱します
- 各 PF の結果を個別に残し、全体比較では規模の大きい案件だけに引っ張られないよう PF を同じ重みで見ます
実験②: モデル比較
| 項目 | 内容 |
|---|---|
| 目的 | 同じ入力と指示でも、モデルの違いによって QA テストケースの網羅性と無駄の少なさがどれだけ変わるかを確認し、QA テストケース生成に最適なモデルを選びます。 |
| 仮説 | Opus 5 が最も高い再現率になると仮定します。 |
| 変更する条件 | モデル: Opus 5 (effort: max) / GPT-5.6-sol (effort: xhigh) |
| 固定する条件 | プロンプト: 最低限のみ コンテキスト: フルコンテキスト |
| 実施方法 | 同じ案件・PF に対して、モデルだけを変えて生成と評価を実行します。 |
| 評価指標 | 再現率、適合率、総合点(F1 スコア) |
4-5. 実験①の結果
実験①: コンテキスト設計の比較結果
各段階で取得済みの PF を平均した値(平均 ± 標本標準偏差 で表記)。合計 7 PF での集計結果です。
| 指標 | 仕様書のみ | +補助情報 | +コード | +対話で仕様確定 | +テスト観点 (提案手法) |
|---|---|---|---|---|---|
| 再現率 | 31.9 % ± 17.5 % | 37.1 % ± 13.2 % | 37.5 % ± 15.2 % | 47.9 % ± 23.2 % | 69.2 % ± 11.4 % |
| 適合率 | 26.9 % ± 19.0 % | 28.3 % ± 17.7 % | 27.7 % ± 19.3 % | 31.8 % ± 17.7 % | 35.5 % ± 18.1 % |
| 総合点 | 26.2 % ± 12.7 % | 28.2 % ± 9.3 % | 28.0 % ± 12.2 % | 34.7 % ± 14.3 % | 45.4 % ± 17.6 % |
提案手法の再現率は 69.2 % に達しました。仕様書のみの場合(31.9 %)と比べると、提案手法の再現率は +37.3 %(約 2.2 倍)となりました。正例 QA テストケースの 5 項目すべての一致を求める厳しい評価指標でも、7 割近い再現率を達成しています。また、適合率も、仕様書のみの 26.9 % から段階 5 では 35.5 % へ向上しました。
PF 別再現率
| 対象 | 仕様書のみ | +補助情報 | +コード | +対話で仕様確定 | +テスト観点 (提案手法) |
|---|---|---|---|---|---|
| A / 管理画面 | 23.1 % | 24.4 % | 38.5 % | 43.9 % | 71.0 % |
| B / 管理画面 | 6.0 % | 19.8 % | 11.2 % | 17.2 % | 77.6 % |
| C / 管理画面 | 38.4 % | 33.3 % | 33.3 % | 38.4 % | 75.4 % |
| A / ユーザー面 | 42.9 % | 54.3 % | 54.3 % | 60.0 % | 80.0 % |
| B / ユーザー面 | 32.4 % | 37.1 % | 28.6 % | 28.6 % | 74.3 % |
| C / ユーザー面 | 60.0 % | 37.5 % | 55.0 % | 60.0 % | 52.5 % |
| D / ユーザー面 | 20.2 % | 53.5 % | 41.4 % | 86.9 % | 53.5 % |
提案手法は、全 7 PF のうち 5 PF で最も高い再現率となりました。最高値にならなかったのは、いずれもユーザー面でした。
一方で管理画面の平均再現率は、+対話で仕様確定の 33.2 % から 74.7 % へ +41.5 % 向上しました。提案手法は管理画面全体の精度を、大きく向上させました。
4-6. 実験①の考察
- 対話による仕様確定は、QA テストケースの品質を安定して押し上げる
平均再現率は、コード追加後の 37.5 % から対話で仕様を確定した後の 47.9 % へ +10.4 % 上昇しました。PF 別では、7 PF 中 6 PF で上昇し、1 PF で横ばいで、低下した PF はありませんでした。この結果から、仕様書や補助情報だけでは決めきれない事項を対話によって確定することは、QA テストケースの再現率向上に有効であることが示唆されます。
さらに、対話による仕様確定には、仕様書の記載不足やソース間の矛盾を開発フローの早い段階で顕在化させる効果もあります。これにより、実装後の手戻りや、仕様の認識差を解消するためのコミュニケーションコストを抑えられる可能性が高いです。 - テスト観点の追加による効果は大きいものの、案件や PF によって差がある
平均再現率は、対話で仕様を確定した後の 47.9 % から 69.2 % へ +21.3 % 上昇しました。特に、管理画面 3 PF の平均は 33.2 % から 74.7 % へ +41.5 % と大きく伸びました。これは、個別の仕様書には明示されにくい管理画面共通の QA テストケースの観点を、テスト観点が補完した可能性を示しています。
一方、ユーザー面 4 PF の平均は 58.9 % → 65.1 %(+6.2 %)にとどまり、PF ごとの増減も大きい結果でした。ユーザー面では仕様書に期待動作が比較的詳しく記載されているため、テスト観点による追加余地が小さく、対象との関連が薄い共通パターンがノイズになった可能性もあります。
以上から、テスト観点は、仕様書に明示されにくい共通観点が多い対象で特に効果を発揮すると考えられます。一方、仕様が十分に記載されている対象では、案件との関連性に基づいてテスト観点を選別する仕組みが必要です。 - コードの追加の効果は指標によって異なる
補助情報まで加えた条件にコードを追加すると、平均再現率は 37.1 % → 37.5 %(+0.4 %)とほぼ変化がなく、適合率は 28.3 % → 27.7 %(−0.6 %)、F1 スコアは 28.2 % → 28.0 %(−0.2 %)とわずかに低下しました。今回の結果では、コードによって仕様を具体化する利点よりも、QA テストケース作成に直接関係しない情報が増えることによるノイズの影響がやや上回った可能性があります。コードを一律に追加するのではなく、対象機能や確認観点に関係する箇所を選別して与える必要があります。 - 補助情報の追加は、3 指標の平均値をいずれも改善する
仕様書のみの条件に企画書・Slack・デザインを加えると、平均再現率は 31.9 % → 37.1 %(+5.2 %)、適合率は 26.9 % → 28.3 %(+1.4 %)、F1 スコアは 26.2 % → 28.2 %(+2.0 %)となりました。補助情報が、仕様書だけでは不足する目的・スコープ・UI 状態・受入条件を補い、QA テストケースの網羅性と無駄の少なさの両方に寄与したと考えられます。
4-7. 実験②の結果
全 7 PF を対象に、生成モデルのみを GPT-5.6-sol と Opus 5 に切り替えて比較しました。両条件では、同一のプロンプトと、補助情報・コード・対話で確定した仕様・抽出したテスト観点・抽出元の過去の QA テストケースを含む同一のフルコンテキストを使用しています。全体値は、各 PF の指標を同じ重みで平均した値です(平均 ± 標本標準偏差)。
| 指標 | GPT-5.6-sol | Opus 5 | 差 (Opus 5 – GPT-5.6-sol) |
|---|---|---|---|
| 再現率 | 64.6 % ± 15.2 % | 69.2 % ± 11.4 % | +4.6 % |
| 適合率 | 28.9 % ± 22.1 % | 35.5 % ± 18.1 % | +6.6 % |
| F1 スコア | 36.9 % ± 23.9 % | 45.4 % ± 17.6 % | +8.5 % |
PF 別の比較
| 対象 | GPT-5.6-sol 再現率 |
Opus 5 再現率 |
|---|---|---|
| A / 管理画面 | 81.0 % | 71.0 % |
| B / 管理画面 | 81.0 % | 77.6 % |
| C / 管理画面 | 60.8 % | 75.4 % |
| A / ユーザー面 | 48.6 % | 80.0 % |
| B / ユーザー面 | 73.3 % | 74.3 % |
| C / ユーザー面 | 65.0 % | 52.5 % |
| D / ユーザー面 | 42.4 % | 53.5 % |
4-8. 実験②の考察
- 仮説通り、Opus 5 の平均再現率が GPT-5.6-sol をやや上回った
平均再現率は、Opus 5 が 69.2 %、GPT-5.6-sol が 64.6 % で、差は 4.6 % でした。PF 別でも、Opus 5 が 7 PF 中 4 PF、GPT-5.6-sol が 3 PF で上回っており、大差はないものの Opus 5 がやや優勢でした。 - Opus 5 は、適合率と F1 スコアでも上回る
Opus 5 は GPT-5.6-sol より平均適合率が 6.6 %、平均 F1 スコアが 8.5 % 高い結果でした。PF 別でも、Opus 5 は適合率と F1 スコアの双方で 7 PF 中 6 PF を上回りました。再現率・適合率・F1 スコアのすべてで Opus 5 が優位という結果になりました。 - モデルによる差は、案件や PF によって大きく異なる
B / 管理画面では GPT-5.6-sol の再現率が Opus 5 より 3.4 %、適合率が 4.9 % 高い結果でした。一方、A / ユーザー面では Opus 5 の再現率が 31.4 %、F1 スコアが 36.8 % 高い結果でした。A / ユーザー面では GPT-5.6-sol が 770 件の QA テストケースを生成したのに対し、Opus 5 は 127 件であり、生成量の大きさが GPT-5.6-sol の適合率低下の一因になった可能性があります。 - 同じ案件内でも、再現率と総合品質の優位性は一致しない
A / 管理画面では、GPT-5.6-sol の再現率が 81.0 % で、Opus 5 の 71.0 % を 10.0 % 上回りました。その一方、適合率は Opus 5 が 7.5 %、F1 スコアは 2.4 % 高い結果でした。多くの正例を再現するだけでなく、生成 QA テストケースの量と重複を抑えることが総合品質に影響します。 - Opus 5 と GPT-5.6-sol の併用には、再現率をさらに引き上げる余地がある
両モデルは異なる PF で高い再現率を示しており、得意領域が補完関係にあります。両モデルで独立に QA テストケースを生成し、統合工程で観点をマージする方法により、単一モデルを上回る可能性があります。今後、併用方法を実装し、実測値で効果を検証する必要があります。
4-9. 追加実験:大規模入力における限界
案件 E は、正例 QA テストケースがユーザー面 348 件・管理画面 940 件と、他の案件(35~221 件)の 4 倍以上の規模でした。この規模の違いが結果へ与える影響を確認するため、追加実験を行いました。
| 案件 | ファイル | 行数 | 規模 |
|---|---|---|---|
| E | ユーザー面 + 管理画面 | 348 + 940 | 極端に大きい |
4-9-1. 実験①(コンテキスト比較)における案件 E の結果
| PF | 仕様書のみ | +補助情報 | +コード | +対話で仕様確定 | +テスト観点 (提案手法) |
|---|---|---|---|---|---|
| E / 管理画面(再現率) | 3.0 % | 4.7 % | 6.3 % | 4.6 % | 7.1 % |
| E / ユーザー面(再現率) | 41.1 % | 60.9 % | 51.7 % | 55.2 % | 50.3 % |
他の管理画面 PF が段階 5(提案手法)で 71.0~77.6 % の再現率に達したのに対し、案件 E / 管理画面は 7.1 % にとどまりました。正例 QA テストケースが 940 件と、他の管理画面 PF (221 件・125 件・116 件)より 4 倍以上多く、入力・出力のトークン量が非常に大きいため、単一の Opus 5 では十分に処理しきれなかった可能性があります。生成 QA テストケースと正例 QA テストケースを比較すると、この PF では他の案件よりも多くの QA テストケースの観点が欠落していました。
4-9-2. 実験②(モデル比較)における案件 E の結果
| PF | GPT-5.6-sol 再現率 / 適合率 / F1 |
Opus 5 再現率 / 適合率 / F1 |
|---|---|---|
| E / 管理画面 | 49.8 % / 34.0 % / 40.4 % | 7.1 % / 15.6 % / 9.8 % |
| E / ユーザー面 | 52.9 % / 14.1 % / 22.3 % | 50.3 % / 23.0 % / 31.6 % |
E / 管理画面では、GPT-5.6-sol の再現率が 49.8 % だったのに対し、Opus 5 は 7.1 % にとどまりました。
4-9-3. 考察
案件 E / 管理画面では、案件規模の大きさと Opus 5 の再現率の低さが同時に現れており、入出力のトークン量が Opus 5 にとってボトルネックになった可能性があります。大規模な入力によってモデルの注意が分散したことや、出力量の大きさによって必要な観点を十分に網羅できなかったことが原因として考えられます。
改善策として、機能や画面単位で処理を分割し、複数のエージェントが生成した結果を統合する方法が考えられます。入出力のサイズを抑えることで精度低下を防げるか、追加検証が必要です。
5. 実運用
「4. 実験」で示した定量評価に加え、試験運用を通じて QA エンジニアからのフィードバックを得たうえで、提案手法は実運用への移行を判断しました。本章では、実運用に至るまでの評価内容と、移行後の運用体制の変化を説明します。
5-1. 実運用までの経緯
実運用への移行は、次の 2 つの評価を組み合わせて判断しました。
- 定量評価 — 「4. 実験」で示した再現率などの指標
- 定性評価 — 試験運用で生成した QA テストケースに対する、QA エンジニアによるレビュー
この両方の評価を得たうえで、十分な品質に達していると判断し、実運用へ移行しました。
5-2. 定性評価:QA エンジニアによるレビュー
「4. 実験」の対象案件とは別に、ユーザー面と管理画面の 2 PF にまたがる新規機能を対象として QA テストケースを生成し、QA エンジニアにレビューを依頼しました。その結果、ユーザー面・管理画面を合わせて、実質的な指摘は 1 件でした。
この結果から、生成した QA テストケースは、実務で運用する QA エンジニアの目線でも大きな不足や誤りがないレベルに達していると判断しました。
5-3. 定量評価と運用可否の判断
「4. 実験」で示した再現率は、厳しめな基準による評価でも 約 7 割に達しています。この精度に加え、今後さらに調整を重ねることで向上余地があることも踏まえ、実運用へ移行するために十分な水準だと判断しました。
この移行により、QA テストケース作成の主な作業は、人がすべてを作成するフェーズから、AI が生成した QA テストケースを人がレビューするフェーズへと変わりました。
6. 結論
本記事では、Opus 5 を用い、分散した仕様情報を自律的に探索し、対話によって不確定事項を解消したうえで、過去の QA テストケースから抽出したテスト観点を活用する QA テストケース生成手法を提案しました。
実験① では、仕様書のみの平均再現率 31.9 % に対し、提案手法では 69.2 % に達し、これまで人手で運用してきた QA テストケースのうち、約 7 割を AI が生成できるようになりました。
実験②では、同一のプロンプトとフルコンテキストを用いて生成モデルのみを比較した結果、Opus 5 と GPT-5.6-sol の平均再現率は 69.2 % と 64.6 % で、Opus 5 が 4.6 % 上回りました。加えて、Opus 5 は平均適合率で +6.6 %、平均 F1 スコアで +8.5 % 上回りました。再現率・適合率・F1 スコアのすべてで、Opus 5 が優位という結果になりました。
なお、正例 QA テストケースが極端に多い案件(案件 E)では Opus 5 の再現率が大きく低下し、大規模入力が単一エージェントでの処理の限界となる可能性が示唆されました。
また、提案手法には、QA テストケースの再現率向上に加えて、二つの実務上の利点があります。
- 対話による仕様確定を通じて、仕様そのものの品質を高められる
仕様書の記載漏れや、仕様書・企画書・チャット・デザイン間の矛盾を不確定事項として明示し、関係者との対話によって解消できます。これにより、QA テストケース作成だけでなく、実装前に仕様の認識を揃え、手戻りやコミュニケーションコストを抑える効果も期待できます。 - 他部署へ転用しやすい
スキル本文には部署固有の知識をほとんど記述せず、それらを過去の QA テストケースと仕様書の組み合わせからテスト観点として抽出する構成にしています。部署固有の情報をスキルへハードコードしていないため、転用先の過去の QA テストケースからテスト観点を抽出し直すことで、スキルの中核部分を大きく変更せずに他部署へ展開できます。
以上から、提案手法は単に QA テストケースを AI 生成する仕組みではなく、分散した仕様と組織内の QA テストケース作成の知識を整理し、不確定事項を対話で解消する仕組みであると位置づけられます。
7. 今後の展開
今後は、実験①・②で明らかになった課題とモデル間の補完性を活かし、より高精度で、他部署でも継続的に運用できる仕組みへ発展させます。
7-1. Opus 5 と GPT-5.6-sol を組み合わせる
実験② では、両モデルの平均再現率の差は 4.6 % にとどまりましたが、PF ごとに再現率が高いモデルは異なりました。各 PF で高い結果を採用した場合の平均再現率は 72.9 % であり、GPT-5.6-sol 単独より +8.3 %、Opus 5 単独より +3.7 % の向上余地があります。
この補完関係を利用するため、両モデルで独立に QA テストケースを生成し、統合工程で観点をマージして重複や不要項目を除く方式を検証します。
7-2. 対象に関連する入力だけを選別する
実験① では、コードを追加すると平均再現率がわずかに低下し、テスト観点の効果も案件や PF によってばらつきました。今後は、対象の画面・機能・データ・確認観点との関連性に基づいて、必要なコード、仕様、テスト観点、抽出用の過去の QA テストケースだけを選択する工程を追加します。すべての情報を与える条件と、関連情報だけを選別する条件を比較し、入力の選別によって再現率と適合率を両立できるかを検証します。
7-3. 大規模案件を分割して処理する
QA テストケース数が特に多い PF では、他の PF よりも多くの QA テストケースの観点が欠落し、再現率が大きく低下しました。大規模な入力と出力を一つのモデルで処理することが、ボトルネックになった可能性があります。今後は、画面・機能・状態・QA テストケースの観点などの単位で処理を分割し、複数のエージェントが生成した結果を最後に統合・重複排除する方法を検証します。単一エージェントの場合と比較し、分割によって網羅性を維持できるかを確認します。
7-4. 他部署への転用可能性を検証する
本手法は、部署固有の知識をスキル本文に記述せず、導入時に過去の QA テストケースと仕様書からテスト観点として抽出する構成です。次の段階では、別部署の過去の QA テストケースと仕様書を用いてテスト観点を一度だけ抽出・保存し、その部署の新規案件で QA テストケースを生成します。導入に必要な作業量、再現率、追加修正の量を確認し、スキルの中核部分を変更せずに展開できるかを検証します。
付録 A. 用語
付録 A. 用語
| 用語 | 定義 |
|---|---|
| PF | プラットフォームまたはテスト対象面を指します。1 案件にユーザー面と管理画面がある場合は、別の PF として扱います |
| 正例 QA テストケース | 人手で作成され、実際に運用された既存の QA テストケースです。生成時には渡さず、評価時だけ参照します |
| 完全一致 | 正例 QA テストケースの「場所・対象・前提・操作・結果」が、すべて生成 QA テストケースで再現されている状態です |
| 再現率 | 完全一致した正例 QA テストケース数 ÷ 正例 QA テストケース数です。実験の主指標として扱います |
| 適合率 | 完全一致の再現に使われた生成 QA テストケース数 ÷ 生成 QA テストケース数です |
| F1 スコア | 再現率と適合率の調和平均です |
| 対話による仕様確定 | 仕様や補助入力だけでは確定しない項目を対話で解消し、その回答を生成コンテキストへ加えた状態です |