

はじめに
こんにちは。グループIT推進本部の Roki です。
AIエージェントにPRレビューを手伝わせる場面が増えると、エージェントに何を読ませるかが問題になります。差分だけでは変更の影響範囲を判断しにくく、かといってリポジトリ全体を読ませるのはトークンと時間の面で割に合いません。私は、コードベースの構造グラフから影響範囲や実行フローを問い合わせられるOSSであるcode-review-graphを、MCP(Model Context Protocol)経由でPRレビューの補助証拠として利用しています[1]。
ところが、一つのセッションの中で複数PRのレビューを並列に進める使い方、つまりPRごとにGit worktreeを分けて同時に扱おうとした時点で、それまでの構成は成り立たなくなりました。
本記事では、このMCPランチャーを2段階で作り直し、一つのstdio MCPセッションからworktreeごとに独立した子プロセスとグラフDBを安全に使い分けられるようにした設計と実装を紹介します。実装は、以前の記事「chezmoiで始めるdotfile管理 〜AIエージェント設定を複数ツールと複数マシンで共有する〜」で紹介したchezmoi管理のdotfilesリポジトリに置いています。あわせて、同じ仕組みをupstreamへ提案した際に、自前のラッパー層から何を変えたかについても触れます。
code-review-graphとは
code-review-graphは、リポジトリをTree-sitterで解析し[2]、関数、クラス、インポートをノード、呼び出し、継承、テストとの対応をエッジとする構造グラフを作り、それを.code-review-graph/配下のSQLiteファイル一つに保持するツールです。ライセンスはMITで、実行にはPython 3.10以上が必要です[1]。
このツールの狙いは、AIコーディングツールにコードベース全体を読ませないことにあります。変更されたファイルからグラフをたどって呼び出し元、依存先、関係するテストを列挙し(upstreamではこれを影響波及範囲、blast radiusと呼んでいます)、レビューに必要な最小限のファイル集合だけを返します。この問い合わせ口がMCPサーバとして実装されており、CLIとMCPサーバは同じDBを共有します。
実装を読むうえで重要になる性質は次のとおりです[1]。
- 増分更新:変更ファイルのSHA-256を確認し、ハッシュが変わったものだけを再解析する。READMEの計測では、約3,000ファイルのリポジトリで2ファイルを編集した場合の更新が約2.5秒(うち約1.4秒はプロセス起動)
- ローカル完結:外部サービスへソースコードを送らない。保存先はSQLiteファイル一つで、外部のDBやクラウドを必要としない
- リポジトリ単位のストレージ:デフォルトの保存先はリポジトリ直下の
.code-review-graph/graph.db。~/.code-review-graph/registry.jsonへ複数のリポジトリを登録でき、data_dirで保存先を個別に指定できる。本記事で扱う問題は、まさにこの保存先の解釈がずれたことに起因する - 幅広い言語対応:Tree-sitterの文法定義がある言語はそれを使い、無い言語には個別の代替処理を適用する。独自言語も設定ファイルで追加できる
- その他の機能:Leiden法によるコミュニティ検出、実行フローの抽出、FTS5による全文検索、任意で有効化できる埋め込み検索、CI用のGitHub Actionなど
READMEにはベンチマークも掲載されています。6リポジトリ、13コミットに対する計測で、質問1件あたりのトークン数は全文を読む場合と比べて中央値で約63分の1(レンジは35〜358倍)、影響解析のF1は平均0.693です。ただし「recall 1.0」は正解集合を同じグラフから作っているため上界に過ぎない、という注記がREADME自身に書かれています[1]。測り方と限界まで開示されているため、数字を鵜呑みにせずに扱うことができます。
プロジェクトの活発さ
自前のラッパーを挟むか、本体に手を入れるかの判断材料として、upstreamの開発状況も確認しました。2026年9月21日時点の数字は次のとおりです[1]。
- リポジトリの作成は2026年2月26日。7か月弱でスター約31,700、フォーク約2,900、コントリビューター123人
- リリースはv2.3.0(2026年4月11日)からv2.3.9(2026年9月18日)まで、おおむね月1回程度の間隔
- コミット数は直近4週で231件、直近12週で654件。ただし週ごとの偏りは大きく、0件の週もあれば168件の週もある
- 未クローズのPRが53本、issueが87件。通算で作成されたPRは648本
- READMEは英語のほか、中国語、日本語、韓国語、ヒンディー語が用意されている
2026年に始まったばかりのプロジェクトが短期間で急速に成長しており、開発はリリース前後に集中するバースト型です。裏を返せば、個々の運用シナリオは利用者が各自で補う前提の段階でもあります。本記事のラッパー層は、まさにその不足を補うために始めたものです。一方で、これだけ人と変更が集まっているのであれば本体へ還元する価値もある、という判断が後半で紹介するupstreamへの提案につながっています。
なお、本記事の構成はバージョン2.3.8に固定して利用しており、記事中の検証もこのバージョンに対して行ったものです。
課題:一つのセッションで複数PRを並列にレビューしたい
レビュー待ちのPRが複数積まれる状況は日常的に発生します。これをエージェントに手伝わせる場合、現実的な運用は一つのセッションを開き、その中で複数PRのレビューを同時に進める形です。PR Aの影響範囲をグラフに問い合わせている間にPR Bの差分を読み、必要であれば両者の指摘を突き合わせてから順に投稿する、といった進め方になります。PRごとにセッションを立て直すのは、立ち上げのコストの面でも、レビュー観点をセッション間で共有できない面でも割に合いません。
この形を取るなら、チェックアウトはPRごとに分かれていなければなりません。一つのチェックアウトをgit switchで往復させると、レビューの最中に足元のチェックアウトが別のPRの都合で切り替わり、読んでいた根拠が崩れてしまいます。また、グラフDBは「ある時点のHEAD」を前提に構築されるため、切り替えのたびに作り直しが必要になります。PRごとに独立した作業ツリーをGitのworktree機能で用意すれば[3]、この問題は解決します。
問題はMCP側にありました。MCPのstdio接続はクライアントがサーバを子プロセスとして起動する形でセッション単位に1本張られ[4]、レビューの途中で張り替えることはできません。にもかかわらず、当時のランチャーは起動時の一つのリポジトリルートに固定されており、tools/callのrepo_rootに別のworktreeを指定しても宛先は変わりませんでした。つまり実質的に「1セッション : 1 worktree」でしか使えなかったのです。複数PRを並列に扱うには、PRごとに別のMCP設定を用意してセッションを分けるか、グラフの利用自体を諦めるか、結局は直列のレビューに戻すしかありませんでした。本記事の変更は、この「1セッション : N worktree」を成立させるためのものです。
変更前の構成とその制約
初期実装のランチャーはPOSIX shで書かれており、起動時のGitルートをSHA-256で要約して、MCP専用の保存領域を作っていました。
repo_root=$(git rev-parse --show-toplevel)
repo_hash=$(printf '%s' "$repo_root" | shasum -a 256 | awk '{print $1}')
data_dir="$project/.crg-data/$repo_hash"これをCRG_DATA_DIRとCRG_HOMEとしてenv -i経由で子プロセスへ渡していました。つまり、ルートのハッシュ単位での隔離は当初から存在していました。異なるルートを別々のMCPプロセスで起動すればDBは確かに分かれるため、ここを「隔離がなかった」と表現するのは不正確です。問題は隔離の有無ではなく、その粒度とCLIとの不一致にありました。
1点目は、1プロセス = 1ルートという粒度です。ランチャーは起動時のカレントディレクトリからルートを一つ決め、それを固定引数として境界検査を担うプロセス(以下guard)とcode-review-graph本体のMCPサーバ(以下本体サーバ)へ渡します。tools/callに別のrepo_rootを指定しても、guardは「起動時ルートの配下か」を検証して弾くだけで、宛先は変わりません。
2点目は、CLIとMCPが別のDBを参照していたことです。CLIは~/.code-review-graph/registry.jsonという登録簿(以下Registry)とリポジトリ直下の.code-review-graph/graph.dbを使うのに対し、MCPはハッシュ名のディレクトリを使っていました。その結果、CLIで構築したグラフがMCPから見えず、両者のノード数、更新時刻、グラフ構築時のGit SHAがそろいません。当時のMCPはbuild_or_update_graph_toolを許可リストから外した読み取り専用の構成で、グラフの構築はCLI側でしか行えなかったため、この不一致は回避できませんでした。レビューの根拠として使う以上、これは致命的です。
第1段階:ストレージの解決規則をCLIとそろえる
最初に直したのはDBの解決規則です。方針は「全リポジトリで一つのDBにする」ことではありません。同じリポジトリルートについて、CLIとMCPが同じ正規のDBを使うことです。前者にすると別のリポジトリのノードが混ざってしまうため、この区別は重要です。
新しい規則は次の2段階で、これはCLIの解決規則そのものです。
- Registryに対象ルートの
data_dirが明示されていれば、それを使う - 明示されていなければ、そのルートの
.code-review-graph/graph.dbを使う
あわせて、全リポジトリに一律に効いてしまうCRG_DATA_DIRは、ランチャーで明示的に拒否するようにしました。保存先をリポジトリ単位で変えたい場合は、Registryのdata_dirで指定します。CRG_HOMEはCLIと基準がずれないよう絶対パスのみを受け付け、未設定であれば~/.code-review-graphを使います。
一方で、本体サーバ自体には広い範囲のRegistryを見せたくありません。そこでguardは一時的なホームディレクトリを作り、対象ルート1件だけを書いたRegistryを子プロセスへ渡します。
(child_crg_home / "registry.json").write_text(
    json.dumps({"repos": [{"path": str(repo_root), "data_dir": str(fixed_data_dir)}]})
)解決には共有のRegistryを使い、子プロセスへ渡すのは解決結果だけにします。こうすることで、CLIとの一致と子プロセスの固定を両立させています。この段階でbuild_or_update_graph_toolも許可リストに加え、MCPからの更新がCLIと同じDBへ書き込まれるようにしました。
第2段階:振り分けプロセスで一つのセッションを多重化する
次に、ランチャーがguardを直接起動するのをやめ、間に振り分け役のPythonプロセス(以下dispatcher)を一つ挟む構成にしました。全体像は次の図のとおりです。
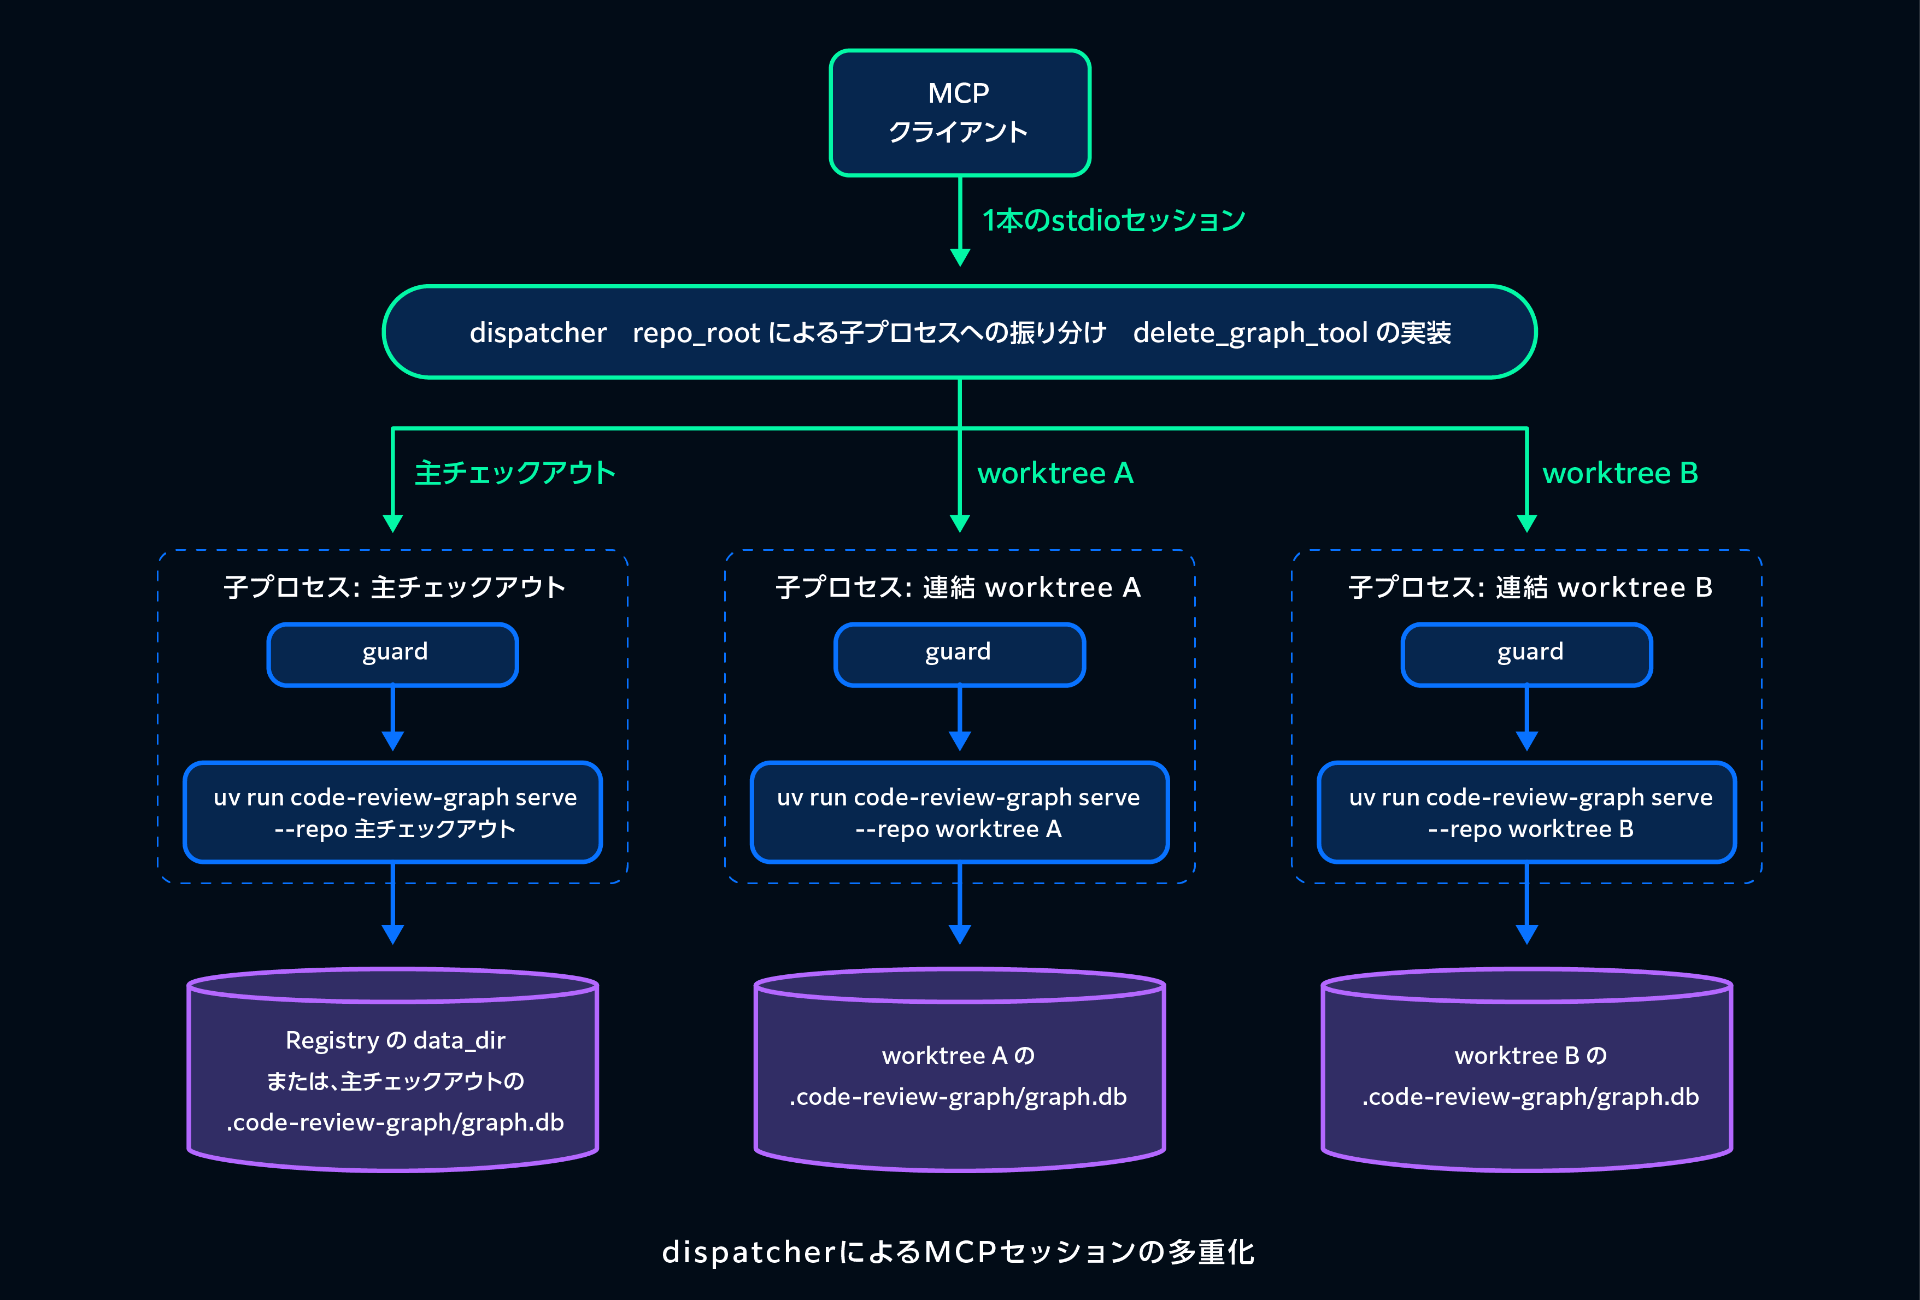
クライアントから見れば、stdio接続は1本のままです。dispatcherはtools/callのarguments.repo_rootを受け取り、正規化と認可を行ったうえで、そのルート専用の子プロセスを遅延起動して要求を振り分けます。同じルートへの要求は同じ子プロセス、同じDBへ届き、子プロセスはそれ以降再利用されます(上限は32)。
並列性はここで効いてきます。dispatcherは要求を子プロセスの標準入力へ書き込んだら直ちに次の入力の処理へ戻り、応答は子プロセスごとの読み取りスレッドが受け取って、共有の標準出力へ書き戻します。したがって異なるルートへの要求を同時に処理でき、PR Aへの重いグラフ問い合わせがPR Bの応答を塞ぐことはありません。更新中の読み取り抑止(後述のgraph_updating)もルート単位で閉じているため、片方のworktreeでグラフを更新していても、もう片方のレビューは進められます。
子プロセスの起動時には、クライアントから送られてきたinitializeのパラメータを、dispatcher内部で生成したIDを使って再生します。そのため子プロセスは、多重化を意識しない通常のMCPサーバとして振る舞えば十分です。tools/listは主チェックアウトの子プロセスへ転送し、その応答にdispatcher自身が実装するdelete_graph_toolを追記して返します。
多重化で最も壊れやすいのは、要求IDの対応付けです。次のように扱っています。
- IDは
json.dumps(value, sort_keys=True)で正規化した文字列をキーにする。数値と文字列の混同や、オブジェクト形式のIDにおけるキー順の揺れを避けるため - キーから子プロセスへの対応表を保持し、同じIDの要求が同時に二つ送られることを拒否する
- 子プロセスから返った応答について「そのIDの持ち主は本当にこの子プロセスか」を照合し、一致しなければ応答を破棄してその子プロセスを停止する
- 上限はメッセージ長4 MiB、ID長4 KiB。超過分は行単位で読み捨て、次のメッセージから復帰する。送信済みで応答待ちの要求は、子プロセスごとに256件まで受け付ける
- 子プロセス側から送られてくる要求には、
pingにのみ空の結果を返し、それ以外は-32601(JSON-RPCのMethod not found)で拒否する[5]
子プロセスが終了した場合は、その子プロセスへ送ったまま応答待ちになっている要求を-32001のエラーとしてクライアントへ返し、対応表から取り除きます。
プロセスの後始末には一段の工夫が必要でした。guardは本体サーバをstart_new_session=Trueで別セッションに置くため、guardを停止しただけでは本体サーバの子孫プロセスが残る可能性があります。そこでguardは起動直後に、本体サーバのプロセスグループIDを、CRG_MCP_UPSTREAM_PGID_FDで渡されたファイル記述子経由でdispatcherへ報告します。dispatcherはこれを保持しておき、停止時には両者へSIGTERMを送り、一定時間後にSIGKILLへ切り替えます。
診断ログの扱いも、実運用では重要でした。子プロセスの標準エラー出力を同期的に書き戻すと、クライアントが標準エラー出力を読まない場合に書き込みが詰まり、プロトコルの入出力ごと止まってしまいます。そのため診断ログは上限64件のキューへ積み、ノンブロッキングに設定したファイル記述子へ専用スレッドから書き込み、あふれた分と64 KiBを超える行は破棄するか切り詰めます。診断ログはあくまで可能な範囲で出力できればよいものであり、JSON-RPCの処理を止めてよい理由にはなりません。
worktreeごとのDB分離とルートの認可
「DBを分けること」と「ルートを許可すること」は別の問題です。DBの分離は前述のRegistryの規則が担い、ルートの認可はdispatcherが担います。
def authorize_root(self, raw_root: object) -> Path:
    root, common = canonical_git_root(raw_root)
    if root == self.primary_root:
        return root
    if common == self.primary_common and root in self.git_worktree_roots():
        return root
    raise DispatchError(
        "repo_root is not the current repository or an authorized linked worktree"
    )
許可されるのは、起動時のルート自身か、同じGit共通ディレクトリ(--git-common-dir)に属し、かつgit worktree list --porcelainに現れるルートだけです。共有のRegistryはDBの保存先の解決には使いますが、認可には使いません。そのため、無関係なリポジトリをRegistryに追加しても認可範囲は広がりません。
canonical_git_rootでは、絶対パスであること、シンボリックリンクでないこと、resolve(strict=True)で解決できること、git rev-parse --show-toplevelの出力が自分自身と一致すること(つまりworktreeのルートであること)、--git-common-dirを解決できることを順に確認します。したがって、任意のディレクトリ、別のクローン、同じリポジトリに属さない一時クローンは許可されません。テストでは、.gitファイルに主リポジトリの参照先を書いただけの偽のworktreeが-32602(JSON-RPCのInvalid params)で拒否されることを確認しています[5]。git worktree listに実在しない以上、.gitの中身を模倣しても認可は通りません。
同じルートへの同時アクセスについては、guardがCRG_HOME/.mcp-locks/<sha256(data_dir)>.lockに共有ロックを取り、SQLiteのWAL[6]とビジー待ち、BEGIN IMMEDIATEによる書き込みロックで整合性を担保します。同一のguard内では、更新の応答が返るまで、読み取りと次の更新をgraph_updatingとして拒否します。
セキュリティ境界
「安全にした」と書くだけでは何も説明したことにならないため、各層で何を拒否しているかを具体的に挙げます。
- ランチャー:実行環境のディレクトリと
tools.txtが、シンボリックリンクではない実体であること。tools.txtの各要素が^[a-z][a-z0-9_]*$に一致すること。書き込みを伴うツール(apply_refactor_tool、embed_graph_tool、generate_wiki_tool、refactor_tool、run_postprocess_tool)を含まないこと。CRG_DATA_DIRを拒否し、CRG_HOMEは絶対パスのみを受け付ける。env -iで環境変数を許可リストに絞り、ホームディレクトリはリポジトリではなく専用の実行時ディレクトリ(パーミッション700)とする。Pythonは3.10以上3.13以下に固定し、UV_PYTHON_DOWNLOADS=neverを設定する - Git:
code-review-graph-gitという薄い中継スクリプトをPATHの先頭に置き、filter.*.clean/smudge/process、diff.*.command/textconv、core.fsmonitorがリポジトリ内の設定にあれば実行を拒否する。git diffには--no-ext-diff --no-textconvを強制する。リポジトリ内の.gitattributesとローカル設定の組み合わせによって任意のコマンドが実行されるのを防ぐため - Registry:所有者が自分自身で、グループとその他のユーザーから書き込めない1 MiB以下の通常ファイルであること。各エントリの
pathとdata_dirが絶対パスかつシンボリックリンクでないこと。複数のリポジトリが同一のdata_dirを指さないこと。同一ルートの重複エントリがないこと - DB:データディレクトリはパーミッション700の実ディレクトリとする。起動時にそのディレクトリのデバイス番号とinode番号を控えておき、以後の操作でこの二つが一致しなければ、同じパスでも中身が別のディレクトリにすり替わったとみなして拒否する。
graph.dbとWAL、SHM、journalの各ファイルにも通常ファイルであることを要求する - ツール引数:
repo_rootは子プロセス自身のルートと完全に一致すること。changed_filesとfile_path_patternはリポジトリ相対で、かつ実体がリポジトリの外へ出ないこと。baseは-で始まる値を禁止する(オプションインジェクションの防止)。get_flow_tool、およびget_review_context_toolとdetect_changes_toolのソース出力は無効化する
古いグラフと誤った紐付けへの対策
グラフが古いまま黙って回答するのは、誤ったレビュー結果を出すのと同じです。読み取り系のツールは、次の条件をすべて満たさない限り結果を返しません。
- DBの
metadataにあるrepository_rootが、現在のルートと一致すること metadataのgit_head_shaが、現在のHEADと一致すること- 作業ツリーに未コミットの変更がないこと
nodesとedgesのfile_pathが、すべて現在のリポジトリ配下に解決されること
条件を満たさない場合はgraph_not_readyあるいはstale_graphを返します。DBが未構築のときに限り、状態確認用としてget_minimal_context_toolを通しますが、由来情報(provenance)が不明なDBに対してはこのツールも通しません。ここでいう由来情報とは、「そのグラフがどのリポジトリの、どのコミットから作られたか」の記録です。
更新側も同様に厳格にしました。未コミットの変更があれば更新自体を拒否し、git ls-filesで追跡対象を列挙して、実体がリポジトリの外に解決されるシンボリックリンクがあれば構築を開始しません。記録済みのSHAが現在のHEADと異なる場合は、増分更新によって古い由来情報が残り続けるのを避けるため、全体の再構築に切り替えます。
更新が成功した後には、完了時点で再検証を行います。確認するのは、RegistryとDBの紐付けが更新中に変わっていないこと、nodesのfile_hashと実ファイルのSHA-256が一致すること、再取得したbuilt_at_shaの値が現在のHEADかつ開始時のHEADと一致し、作業ツリーに変更がないことです。いずれかが崩れていれば成功応答をエラーに書き換え、DBのmetadataにmcp_validation_errorを書き込んで、以後の読み取りを保守的に停止します。この印は、検証済みの再構築が完了した時点でのみ消去されます。読み取りについても、開始時に紐付け、HEAD、未コミット変更の有無、グラフ内容のダイジェストを記録しておき、応答を返す直前に照合して、途中で変化していれば結果を破棄します。
グラフ削除の運用
レビュー中はグラフを読み取り専用の補助証拠として扱い、構築や更新によって状態を変えない、というのが手順書(skill)側の方針です。そのうえで、承認、Linearの更新、Slackのリアクションといった完了条件をすべて満たした後にだけ、対象のworktreeに対してdelete_graph_toolを実行します。このツールはdispatcherが実装しており、次の制約を持ちます。
- 引数は
repo_rootとconfirmationのちょうど二つで、confirmationは"approved"のみを受け付ける - ルートが
authorize_rootを通過すること。さらに、同一セッション中にそのルートへのグラフ操作が1回以上成功していることを要求する - 対象の子プロセスを停止し、データディレクトリが起動時に控えたデバイス番号とinode番号のままであること、つまり削除しようとしている先が当初と同じ実体であることを確認する
- 排他ロックを取得する。他のプロセスが使用中であれば
graph_cleanup_busyで停止する BEGIN IMMEDIATEで書き込みロックを取り、DBのmetadataのrepository_rootが一致することを確認する- 由来情報を持たない旧形式のDBは、リポジトリ内のデフォルトの位置にある場合に限り削除できる。外部の
data_dirに置かれた旧形式のDBは所属を証明できないため削除しない - 削除対象は
graph.dbとWAL、SHM、journalの付随ファイルのみ。ソースファイル、worktree、Registryの登録、任意のパスは削除しない
指摘が残っている場合、承認できなかった場合、MCPの失敗やグラフの古さを検出した場合は削除せず、次回の再レビューのためにグラフを残します。そのため手順書側は、グラフを使った時点の正規のルートをgraph_repo_rootとして保持し、後続の削除処理へそのまま引き渡します。カレントディレクトリや推測したパスで代用することは認めていません。
テストと検証
必要なテストの種類
この構成で壊れると困るのは次の三種類で、いずれも関数単位のテストでは検出できません。
- 境界:許可していないルートや引数が本当に拒否されるか。判定はランチャー(sh)、dispatcher、guard、本体サーバの4層に分散しているため、すべてをつないで動かさないと確かめられない
- ストレージの一致:CLIとMCPが同じDBを指しているか。片方だけを動かしても意味がなく、両方を交互に動かして同じ値が得られることを確認するしかない
- プロセスの後始末:子や孫のプロセスが確実に停止するか。素直に終了する相手でテストしても、何も検証したことにならない
そこで、実際のサーバを起動して標準入出力にJSON-RPCを流す形式を採用し、確認したい失敗が実物では再現しにくい場合にだけ、本体サーバを偽物に差し替えています。なお、以下の確認項目の大半は「拒否されること」の確認です。許可すべき経路は1本しかないのに対し、拒否すべき経路は無数にあるため、この層のテストは自然と否定形が中心になります。
テストの実装方針
テストスクリプトは2本ともPOSIX shで書き、その中からヒアドキュメントでPythonを起動してクライアント役を担わせています。MCPのクライアントライブラリは使わず、生のJSON-RPCを自前で組み立てて送っています。理由は二つあります。
- ライブラリでは不正なメッセージを送れない:4 MiB超のメッセージ、配列形式の一括要求、オブジェクトでない値、4 KiB超のIDといった「送ってはいけないもの」を意図的に送る必要がある
- 応答の到着順とタイムアウトを自分で制御したい:並列性の確認では二つの要求を続けて送り、どちらが先に返ってもよい形で両方を待つ
実行環境は毎回mktemp -dで作成した一時ディレクトリに閉じ込め、その中に偽のホームディレクトリ、偽のリポジトリ、各スクリプトを配置します。実際のホームディレクトリや作業リポジトリには触れません。
プロセス制御の確認には、uvのふりをする小さなPythonスクリプトを3種類用意しました。
- 応答を返した直後に標準エラー出力へ64 KiB以上を書き続ける「詰まらせる役」
- SIGTERMを無視する孫プロセスを作り、そのPIDをファイルに書き残す「止まらない役」
- 起動しただけで眠り続ける「初期化の途中で落とされる役」
これらがなければ、診断ログの詰まりやプロセスグループ単位の停止は確かめようがありません。逆に、グラフの中身に関わる確認は偽物では意味がないため、そちらは実際の本体サーバを動かして確認します。
判定はシンプルにしています。Python側は条件を満たさなければ例外を送出して即座に終了し、シェル側はtestとexit 1で失敗させます。テストフレームワークは使っていません。CLIとMCPの値を突き合わせる箇所だけは、MCPから得た値をいったんファイルに書き出し、MCPプロセスを終了させてから、シェル側でjqとsqlite3を使ってCLIの出力やDBの中身と比較する形にしました。サーバの終了後に確認することで、応答に含まれていた数値が確かにDBへ書き込み済みのものだと言えるためです。
確認している項目
code-review-graph-smoke-test.shは、境界とプロセスの後始末を担当します。確認している項目は次のとおりです。
uv lock --checkが通り、本体のバージョンが2.3.8で一致することinitializeの応答確認tools/listの結果が、許可リストにdelete_graph_toolを加えたものと完全に一致することrepo_root: "/"や、外部を指すシンボリックリンクを含むchanged_filesが拒否されること- 一括要求、不正なJSON、オブジェクトでない値、4 KiB超のIDが拒否されること
- 4 MiB超のメッセージでの停止と、1,100段ネストしたJSONを送った後でも
pingが通ること - SIGTERMを無視する孫プロセスが、プロセスグループ単位で確実に停止すること
- 標準エラー出力を読まないクライアントでも、標準出力の応答が返ること
.gitattributes経由のdiffドライバやfilterを発火させないこと- リポジトリ内にDBが作られていないこと
code-review-graph-shared-storage-test.shは、CLIとMCPの往復を実際の本体サーバで確認します。
- CLIで
registerとbuildを実行した後、MCPのlist_graph_stats_toolが返すノード数がCLIのstatus --jsonと一致すること。MCPから更新した後も、CLI側の値と、DBのrepository_root、git_head_sha、count(*) from nodesが一致すること - 未コミットの変更がある状態と、コミット後に古くなったグラフが、それぞれ
stale_graphで拒否されること - Registryの
data_dirの書き換えと重複エントリが拒否されること。一方で、無関係なリポジトリを追加しても稼働中の子プロセスが中断されないこと git worktree addで作成した連結worktreeについて、主チェックアウトとDBが別物であること。一つのMCPセッションから両方の統計を取得し、それぞれがCLIの値と一致し、かつ互いに異なること- 偽のworktreeと不正な
confirmationが拒否されること。別途起動したguardがロックを保持している間はgraph_cleanup_busyとなり、ロックの解放後は削除に成功して付随ファイルも消えること。他のリポジトリのDBとRegistryの登録が残ること。削除後にgraph_not_readyの状態へ戻ること - 追跡対象に外部を指すシンボリックリンクを含むコミットへの更新が拒否され、DBの
git_head_shaが更新されていないこと
このほか静的な検査として、sh -nによるシェルスクリプトの構文検査と、python -m py_compileによるdispatcherとguardのコンパイル検査を実施しており、いずれも通過しています。上記の2本は本体パッケージの取得が必要なため、コミット時の自動検査には含めず、MCP周りを変更したときに明示的に実行する運用としています。本記事の執筆時点で、いずれも成功することを確認済みです。
upstreamへの還元:–multi-worktreeモード
ここまでの構成は、dotfiles側のラッパー層に閉じたものです。しかし「一つのセッションから複数のworktreeを扱いたい」という要求自体は、code-review-graphを使う誰にでも生じうるものです。そこで同じ仕組みを、明示的に有効化したときだけ動作する本体のモードとして、PR #1063で提案しました[7]。変更の中心は、新規モジュール一つ(multi_worktree.py)とCLIフラグの追加です。
code-review-graph serve --multi-worktree --repo /path/to/primary-repositoryこのPRの方針は次のとおりです。
デフォルトの挙動を変えない。--multi-worktreeを明示しない限り、従来どおり単一ルートのサーバが起動します。新しいモードはstdio専用で、--httpとの併用は引数解析の段階で弾きます。
責務をプロセス隔離と振り分けに絞る。本体が行うのは、「ルートごとに通常のserve --repo <root>子プロセスを遅延起動し、要求を振り分ける」ことだけです。グラフの鮮度判定や由来情報の検証、削除処理といったレビュー運用に固有の関心事は一切持ち込んでいません。それらは呼び出し側(ラッパーや手順書)の責務として残しています。本体が引き受けるのは、「worktreeごとに状態を混ぜない」という一点です。
認可規則はラッパー層と同じにする。絶対パスであること、git rev-parse --show-toplevelの自己一致、--git-common-dirの一致、git worktree list --porcelainへの実在を確認します。別のリポジトリや、既に削除されたworktreeのパスは通りません。Gitの実行時にはGIT_*の環境変数をすべて取り除き、設定を隔離します。
DBの重複割り当てを直接拒否する。ラッパー層ではRegistryのdata_dirの重複として検査していましたが、本体側ではDBパスを解決する関数の結果そのものをルートごとに保持し、既に別のルートが使っているDBへ解決された場合は子プロセスの起動を拒否します。設定の書き方ではなく解決後のパスで判定するため、こちらの方が確実です。プロセス全体に効くCRG_DATA_DIRは、すべてのworktreeを一つのDBへ縛ってしまうため起動時に拒否し、子プロセスの環境からも除去します。
子プロセスへ渡す環境変数を許可リストに絞る。HOME、PATH、一部のCRG_*など、必要なキーだけを渡します。起動はpython -cからrunpyで同じパッケージを呼び出す形にし、冒頭でsys.path.pop(0)を実行して、レビュー対象のリポジトリからモジュールが読み込まれるのを防いでいます。
また、ラッパー層から意図的に変えた点が二つあります。
一つ目は、サーバ側から送られてくる要求の扱いです。ラッパー側ではping以外を-32601で拒否していましたが、本体側ではIDをmulti-worktree-server-<uuid>に書き換えて親のクライアントへ転送し、返ってきた応答を元のIDに戻して発信元の子プロセスへ届けます。roots/listのようなクライアント側の機能を将来使えるようにするためで、プロトコルのメッセージを黙って破棄しない方が安全だという判断です。notifications/cancelledも、対象の要求を抱えている子プロセスにだけ送ります。
二つ目は、メッセージ長の上限です。親の標準入力側は4 MiBのままですが、子プロセスの標準出力側は64 MiBまで許容しています。グラフの応答はどうしても大きくなりうるためです。
PRに記載しているとおり、検証はruff、pytest -q(32件成功)、git diff --checkで行っています。エンドツーエンドのテストでは、一つのセッションから二つのworktreeに対してasyncio.gatherで構築と問い合わせを同時に送り、worktree固有のシンボルが片方にしか現れないこと、無関係なリポジトリが拒否されることを確認しています。本記事の執筆時点では、このPRは未マージであり、取り込まれるかどうかは未定です。
制約と今後の課題
現時点の構成には、明示しておくべき制約が三つあります。
第一に、認可範囲は起動時のリポジトリと同じGit共通ディレクトリに閉じています。複数の独立したリポジトリを一つのセッションで横断する用途は想定していません。
第二に、層の切り分けを混同しないよう注意が必要です。初期のMCPラッパーによるハッシュ単位の隔離、本体のCLIが持つリポジトリ単位のストレージ規則、ラッパー層のdispatcherによる同一セッション内の振り分け、そして本体への提案である--multi-worktreeは、それぞれ別の層の話です。現在手元で動いているのはラッパー層の構成であり、本体へは提案した段階で、取り込まれる保証はありません。仮に取り込まれたとしてもラッパー層が不要になるわけではなく、グラフの鮮度検証と削除処理はラッパー側に残ります。
第三に、並列化の効果については定量的な計測を行っていません。子プロセスの上限を32、子プロセスごとの応答待ち要求の上限を256としているのは暴走時の歯止めであり、実測に基づいて調整した値ではありません。
まとめ
本記事では、code-review-graphのMCPランチャーを2段階で作り直し、一つのstdio MCPセッションからGit worktreeごとに独立した子プロセスとグラフDBを使い分けられるようにした設計と実装を紹介しました。最後に、この取り組みから得られた知見を四つにまとめます。
第一に、隔離について考えるときは、まず粒度を決めるべきでした。初期実装にもルートのハッシュ単位の隔離はありましたが、それは「1プロセス = 1ルート」であり、求めていた「1セッション = N worktree」とは別物でした。問うべきは「隔離されているか」ではなく、「何の単位で隔離されているか」です。
第二に、複数の経路から同じ状態を扱うのであれば、解決規則そのものを共有すべきです。CLIとMCPでDBパスの導出を二重に実装していたことが不一致の原因であり、同じ2段階の規則を両者が使う形にした時点で問題は解消しました。DBを一つに統合したわけではない点は、改めて強調しておきます。
第三に、グラフのような派生データは、由来情報を持たないまま返してはいけません。repository_rootとbuilt_at_shaをDBに持たせ、現在のルートとHEADに照らして一致しなければ回答しない。この単純な規律が、多重化において最も効果のあった安全装置でした。
第四に、手元で組んだ仕組みをupstreamへ提案する際には、責務を削る方向に考えることになります。ラッパー層では振り分け、鮮度検証、削除処理を一つの層に詰め込んでいましたが、本体へ提案したのは振り分けとプロセス隔離だけです。誰にでも必要な機構は本体へ、自分のレビュー運用に固有の規律はラッパーへ。この線引きを先に済ませておくと、提案する差分は自然と小さくなります。
AIエージェントを用いたコードレビューを並列に進める際の構成の一例として、本記事が参考になれば幸いです。
参考文献
[1] code-review-graph GitHub Repository https://github.com/tirth8205/code-review-graph
[2] Tree-sitter公式ドキュメント https://tree-sitter.github.io/tree-sitter/
[3] Git公式ドキュメント「git-worktree」 https://git-scm.com/docs/git-worktree
[4] Model Context Protocol Specification(2025-06-18)「Transports」 https://modelcontextprotocol.io/specification/2025-06-18/basic/transports
[5] JSON-RPC 2.0 Specification https://www.jsonrpc.org/specification
[6] SQLite公式ドキュメント「Write-Ahead Logging」 https://www.sqlite.org/wal.html
[7] tirth8205/code-review-graph Pull Request #1063 https://github.com/tirth8205/code-review-graph/pull/1063