

はじめに
こんにちは、2026 年入社のソフトウェアエンジニア、イム・ヒョンギュです。5 月にドットマネーに配属され、9 月からは Amebaブログで今回の移行を担当しました。
Amebaブログのジャンル・ランキング・ハッシュタグのページを、Node.js 14 のレガシー構成から Next.js(App Router)で作り直し、AWS EKS 上の社内基盤へ移しました。2026 年 10 月、本番の切り替えを無停止で終えています。
移行先は、Amebaブログの他のフロントエンドと同じ Next.js の monorepo と、社内の EKS 基盤です。CI・デプロイ経路・監視を他のアプリとそろえ、同じチームで保守できるようにすることが目的でした。実装は私 1 人が担当し、設計とコードはチームのレビューと AI レビューで検証しながら進めました。移行で何より大事なのは信頼性だと考え、「見た目と外部との約束は変えずに、中身だけを今の基盤に翻訳する」ことと、「切り替えるより先に、戻し方を用意する」ことを軸に進めました。
切り替えは、新旧比較で予期しない差分がないことを確認してから進めました。また切り替え前の負荷試験では、ピークに届く前に飽和する問題を見つけて直しています。
この記事では、本番を止めずに安全に切り替えるためにやった 4 つのことを中心に紹介します。
- 新旧を自動で突き合わせる Regression Runner
- CloudFront の KVS で origin を切り替える rollback の仕組み
- 本番環境への負荷試験
- wildcard alias を経由した無停止の切り替え
背景:EOL から 3 年以上たった Node 14 で動いていたページ
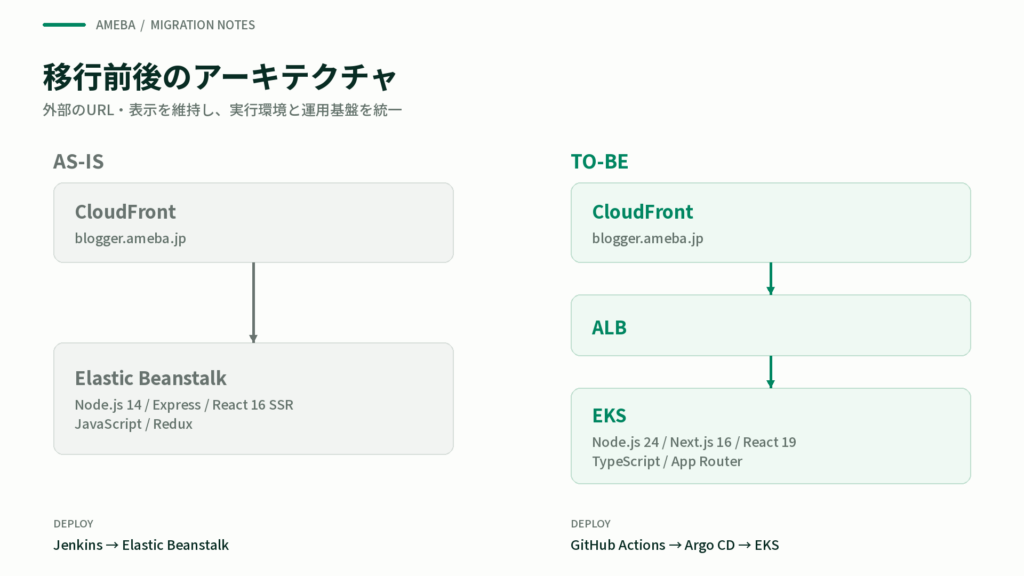
移行前のアプリは、2023 年 4 月に EOL を迎えた Node 14 の上で、Express と React 16 の SSR で動いていました。
| 観点 | 移行前(AS-IS) | 移行後(TO-BE) |
|---|---|---|
| ランタイム | Node 14 | Node 24 |
| フレームワーク | Express + React 16(renderToString)+ Redux | Next.js 16(App Router)+ React 19 |
| 言語 | JavaScript のみ | TypeScript + zod |
| テスト | テストファイル 11 個 | テストファイル:アプリ 121 個 + UI 169 個、Storybook、VRT |
| デプロイ | Jenkins → Elastic Beanstalk | GitHub Actions → Argo CD → EKS |
| 監視 | console ログのみ | 構造化ログ、metrics、APM |
問題は大きく 4 つありました。
- EOL のランタイムで、依存の更新もセキュリティ対応も止まっていた
- 他のフロントエンドアプリと CI・デプロイ経路・言語がすべて違い、保守できる人が限られていた
- 監視が弱く、障害の切り分けが難しかった
- upstream の失敗を握りつぶして 200 の空ページを返し、それが CDN に 20 分から数時間残る構造だった
方針:コピーではなく「翻訳」
プロジェクトの最初に、「レガシー構成の copy & paste ではなく、観測可能な動作を保ったまま、今の基盤へ翻訳する」と決めました。
外部契約は変えない
利用者や他のシステムから観測できるものを「外部契約」として固定しました。
- URL、HTTP status、リダイレクト
- PC / SP それぞれの見た目
- 計測(PV や行動ログ)と広告の枠
- SEO(title、canonical、OGP、robots.txt、sitemap)
- 404 ページの見た目と、そのときの計測
たとえば robots.txt はバイト単位で同一、sitemap は約 900 URL がすべて一致することを確認しています。
中身は今の基盤に合わせる
一方で、旧アプリの内部 API(BFF)はサーバー側で取得して SSR する形に置き換えたので移していません。内部ロジックの欠陥も直しました。たとえば upstream の失敗時に 200 の空ページを返していた挙動は、主要データの失敗なら 5xx、補助モジュールの失敗ならその部分だけ外して 200 を返す形に改め、外部契約の例外として合意しています。直したもの・あえて直さなかったものは一覧に残し、レビューで合意しています。
ソースではなく、実際の出力を見る
途中で何度も痛感したのがこれです。
- CSS の単位が逆:旧アプリは font-size が px で padding が rem、新しい共有 UI はその逆でした。ルートの font-size が 16px のときだけ一致します
- グローバル CSS も契約:
a:hoverの下線やbuttonの UA 既定値が見た目を作っていて、コンポーネントの SCSS だけ見て移すと漏れます - 404 の実体:コンポーネントのファイルではロゴだけの画面に見えたのに、実際の出力にはヘッダーとフッターがありました
どれもソースを読むだけでは見落としたものです。この経験が、次の Regression Runner につながりました。
1. Regression Runner:「承認した差分しかない」を機械で確認する
新旧の両方から証拠を集めて外部契約を比較し、単一の HTML レポートにまとめるローカル CLI を作りました。本番の旧アプリと、開発環境の新アプリを並列に叩いて比べます。
比べるのは次の 4 つです。
- HTTP status とリダイレクト
- HTML(head のメタ情報、計測用の DOM など)
- 外部リクエスト(広告や PV の送信)
- 画面のキャプチャ(参考証拠として保存)
差分をゼロにするのではなく、承認した差分だけにする
移行では、意図して変えた部分が必ず出ます。そこで、既知・承認済みの差分を profile に値まで厳密に宣言するようにしました。宣言と 1 文字でも違えば FAIL です。
こうすると、レポートで確認できるのは「差分がある」ではなく「承認した差分しかない」になります。このレポートをレビューの場で確認し、切り替えの gate にしました。
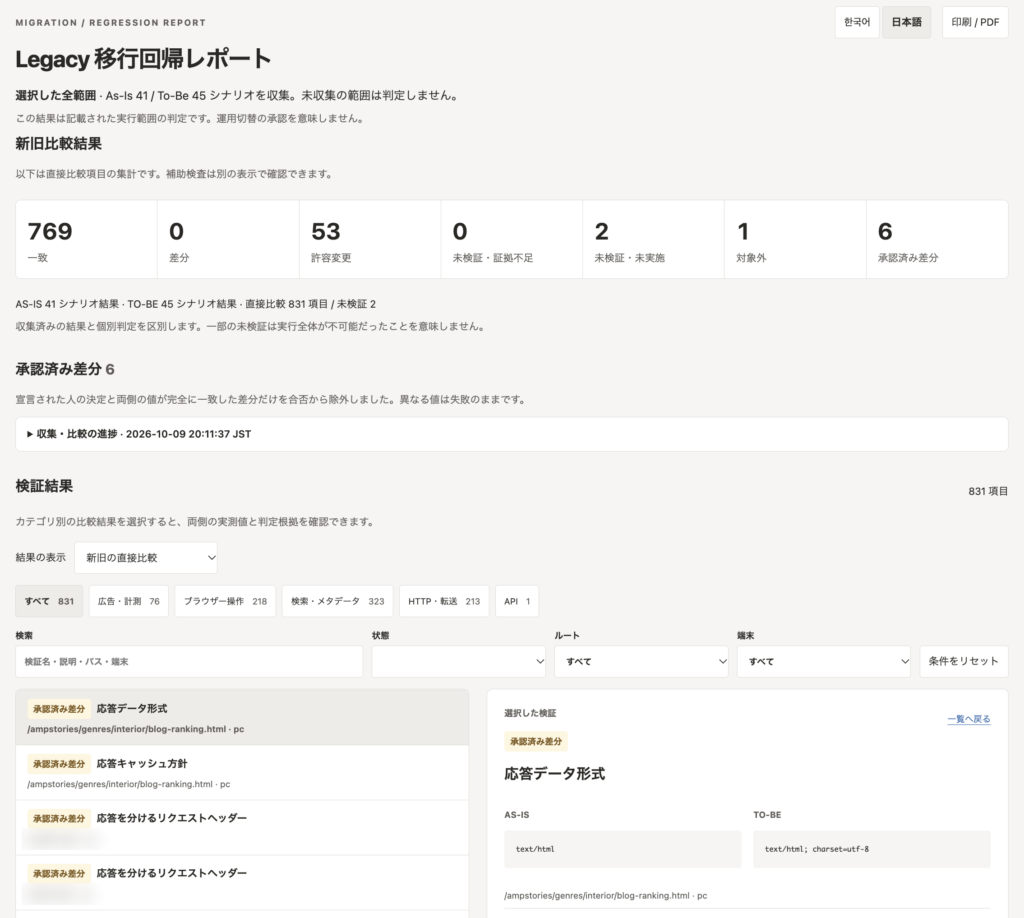
10 月 9 日の dev での実行では、AS-IS 41 / TO-BE 45 のシナリオ(このうちブラウザで画面を開くシナリオは各 27)から、直接比較 831 項目を判定しました。
TO-BE のほうが 4 つ多いのは、新アプリで新設した内部 API のシナリオがあるためです。旧アプリに対応する API がないので、新旧比較では対象外としています。
| 判定 | 件数 |
|---|---|
| 一致 | 769 |
| 比較ポリシーで許容した変更 | 53 |
| 承認済みの差分 | 6 |
| 差分(FAIL) | 0 |
| 未検証 | 2 |
| 対象外 | 1 |
承認済みの差分は、たとえば次のようなものです。
| 比較対象 | 旧アプリ | 新アプリ | 承認した理由 |
|---|---|---|---|
/ampstories/*(AMP 版のランキングページ)の応答 |
200 で HTML を返す | 404 | 新アプリでは AMP 版を作らず、廃止する方針で合意済み。Content-Type や Cache-Control の違いは、これに伴う付随的な差分として値まで宣言 |
存在しないハッシュタグ(404)の <html lang> |
ja |
なし(SSR 時) | Next.js では、page で notFound() を呼んだ 404 がエラー用の文書として返るため、SSR の HTML に lang が付かなかった。JavaScript 有効時はクライアントで lang="ja" を補う |
それぞれの差分には、理由と決定の記録(PR のレビューコメントや作業記録)へのリンクを付けています。
「比較ポリシーで許容した変更」は、PR や作業記録で合意したルート単位の変更方針に沿って、新旧の一致ではなく基準検査で確認した項目です。53 件は次の 3 つに集中しています。
- 404 ページの SEO メタ情報とキャッシュ方針(44 件)。新アプリは 404 に
no-store系の Cache-Control を付け、og:typeを出さない。title や robots(noindex)は値も一致 - 末尾スラッシュの正規化(6 件)。例:
/genres/maternity/は旧アプリでは 200、新アプリでは 308 で/genres/maternityへリダイレクト - AMP 版ランキングの廃止(3 件)
「承認済みの差分」は、項目ごとに値と理由を指定して個別に承認したものです。この 2 つを除くと、検証対象で予期しない差分はありませんでした。未検証と対象外の項目もレポートに明示し、レビューで確認しています。
- 比較は「広告・計測」「ブラウザの動作」「検索・メタデータ」「HTTP・リダイレクト」のカテゴリに分けて判定する
- 判定しないものもレポートに明示する。未検証の 2 件は「操作後の計測・広告配信全体の同等性」と「ランキングなど動的コンテンツの新旧同等性」。対象外の 1 件は、役割の変わった内部 API
- 画素一致や旧 CSS セレクター、DOM 全体の構造は最初から比較対象外。画面キャプチャは自動判定には使わず、人が確認する参考証拠として保存する
本番へのアクセスの影響と比較範囲の管理
- 本番へのリクエストは query なしの URL に限定し、検証用の query で不要なキャッシュのバリエーションを作らない
- 計測や広告のリクエストは遮断せず、実際のブラウザで発生したものを観測している。そのため 1 回の実行で、本番の旧アプリには画面のシナリオ数(27)程度の PV が実際に送られる。日々の PV に比べれば無視できる量
- 開発環境は社内認証の裏にあるので、一度ログインしたセッションを保存して再利用する
- 中断された RSC の prefetch などは「差分」ではなく「観察」として分類する
2. KVS × CloudFront Function で、値 1 つで戻せる状態にする
本番に出す前に、まず「戻し方」を作りました。新しい CloudFront distribution 1 つに、新アプリ(ALB)と旧アプリ(Elastic Beanstalk)の両方を origin として持たせています。
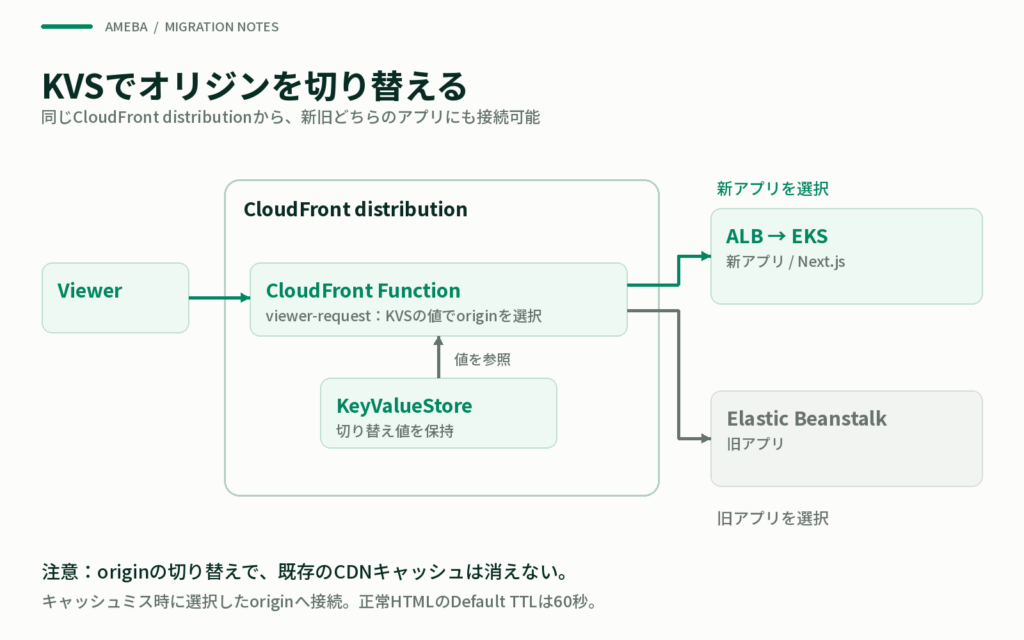
- CloudFront Function がリクエストごとに KVS(Key Value Store)の値を読み、origin を選ぶ
- KVS の値を 1 つ変えるだけで、DNS も distribution の設定も触らずに配信元が切り替わる。反映は数秒
- KVS の読み取りに失敗したり想定外の値だったりしたら、既定の origin である新アプリ(ALB)へ送る。切り替え中に KVS が旧アプリを指している段階でも同じ
KVS の読み取りに失敗したときに旧アプリへ流すと、廃止予定の環境へ予期せずトラフィックが戻ります。切り替え時点の新アプリは負荷試験を通過済みだったため、障害時の既定の送り先は新アプリにしました。
Terraform では KVS の key だけを管理し、値は ignore_changes にしています。運用で切り替えた値が、再 apply で戻らないようにするためです。stg では実際に rollback を試してから本番に進みました。
TTL を短く始めた理由
先に結論を書くと、rollback したときに CDN に残る新しい HTML の寿命は TTL で決まるので、切り替え直後は戻しやすさを優先して TTL を短く始め、ヒット率への影響は旧アプリの CDN ログで確かめました。
KVS で旧アプリに戻しても、CDN にキャッシュ済みの新しい HTML は TTL が切れるまで返り続けます。新旧どちらの origin も正常な HTML に Cache-Control を付けないので、新しい distribution ではどちらにも cache policy の default TTL が適用されます。そこで default 60 秒 / max 600 秒で始めました。max の 600 秒は origin が max-age を返したときだけ効く上限なので、今の構成では HTML は 60 秒で入れ替わり、戻したあとに新しい HTML が残るのも 1 分程度です。旧 distribution の behavior 設定(ハッシュタグ詳細は 10000 秒)のままなら、最大で約 2 時間 46 分残ります。
JS / CSS は別のホストから配信しているため、origin の切り替えの影響を受けません。CDN 上に残った HTML は通常 60 秒で期限切れになります。ただし、すでに開かれているページは自動で更新されないため、そのページから同じオリジンへ送る API や RSC のリクエストは反対側のアプリに届きます。切り替え前後では、こうしたリクエストの互換性に注意が必要です。
TTL を短くするとヒット率が下がる心配があるので、旧アプリの CDN ログ 1 日分を集計しました。
- HTML のユニーク URL の約 95% は、その日 1 回しか要求されていなかった
- TTL が一番長いハッシュタグ詳細でも、約 9 割がミスだった
- 一方、上位のごく一部の URL(HTML リクエストの約 4 割)ではミスは約 1 割で、繰り返し要求される URL ではキャッシュが効いていた
長い TTL だけでは全体のミスを減らしにくい分布で、TTL を短くした影響は主に上位の人気 URL に出ます。切り替え直後は rollback の速さを優先して短く始め、origin へのリクエスト数を見ながら段階的に延ばす方針にしました。
ちなみに、cache policy の query string の whitelist は既定で 10 個までという上限があり、本番の apply で初めて気づきました。アプリが読む query は 11 個あったため、query string をすべてキーにする設定に変えています。
3. 本番環境への負荷試験で、切り替え前に飽和を見つける
手元の計測から見積もったリソースは、origin のピークに届く前に飽和しました。切り替え前に試験したから見つかったものです。
見積もり
旧アプリの CDN ログ 1 日分から、origin まで届いたリクエストのピークを算出しました。以下、負荷の大きさはこの origin のピークを基準(1 倍)として表します。
- origin のピーク(5 分値):1 倍
- edge のキャッシュが全く効かなかった場合のピーク:約 1.3 倍
手元で測った 1 リクエストあたりの CPU 時間を EKS では 2 倍と仮定し、CPU 500m・min 3 pod で始めています。
試験の方法
- 本番環境を DNS を向ける前に構築し、CDN のキャッシュを通らない経路で origin に直接負荷をかけた。一般の利用者のトラフィックの経路は変えていない
- リクエストの Host と SNI は本番と同じにした
- パスは旧アプリの CDN ログから、実際に origin まで届いた GET を 2 万件抽出して再生。経路の比率も実測どおり(ハッシュタグ詳細が最も多く、次いでジャンルのブログランキング)。PC / SP は半々
- 負荷は 1 倍 → 約 1.3 倍 → 約 2 倍の階段(ramping-arrival-rate、各段 8 分)。1 倍は origin のピーク、約 1.3 倍はキャッシュが全く効かなかった場合のピーク、約 2 倍はそこからさらに余裕を見た値
- 本番の試験の前に、2 req/s × 1 分の smoke でシナリオ自体が正しく動くかを確認した(エラー 0 件、p95 約 1.1 秒)
CDN のログは URL をもう一段エスケープして記録する(% が %25 になる)ので、そのまま使ったらハッシュタグのページが全部 404 になりました。smoke の段階で気づけてよかったところです。
結果
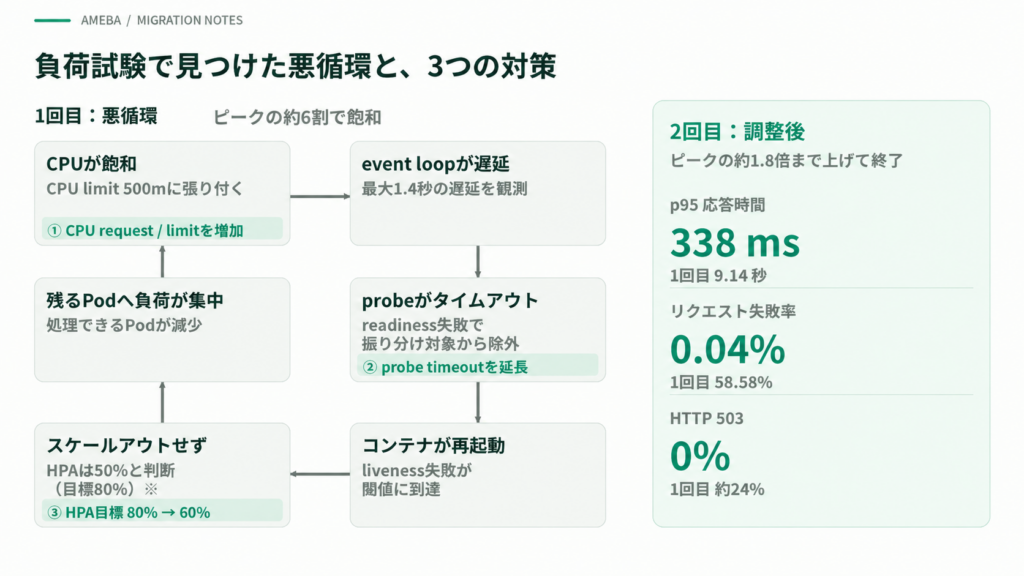
1 回目は、負荷を 1 段目(1 倍)へ上げていく途中、ピークの約 6 割で飽和しはじめ、次の連鎖が起きました。
- pod の CPU が limit の 500m に張り付き、event loop delay が最大 1.4 秒に
- readiness probe(timeout 1 秒)に失敗した pod はトラフィックの振り分け先から外れ、liveness probe の失敗が閾値に達した pod はコンテナが再起動された
- HPA は目標 80% に対して 50% と判断し、スケールアウトしなかった。HPA は Ready でない pod や metrics の取れない pod をスケールアップ判断で保守的に扱うため、再起動中の pod が多い状態では必要台数が低く見積もられたと考えている
- 残りの pod に負荷が集中し、再起動が続いた
対応は 3 つです。
- CPU を request 1000m / limit 1500m に(Node はメインスレッド 1 本なので 1 core まで使えるようにし、GC などの分を limit に残す)
- HPA の目標を 80% から 60% に(飽和してからではなく、飽和前にスケールを始める)
- probe の timeout を延ばす(遅いが生きている pod を殺さない)
※ 2 回の試験は実行時間・到達負荷が異なるため、単純な改善倍率としては比較していません。
| 指標 | 1 回目(CPU 500m) | 2 回目(調整後) |
|---|---|---|
| p95 応答時間 | 9.14 秒 | 338 ms |
| p99 応答時間 | 9.86 秒 | 562 ms |
| リクエスト失敗率 | 58.58% | 0.04% |
| HTTP 503 の割合 | 約 24% | 0% |
※ 応答時間は k6 の expected_response:true 基準で、各回の全体集計です。1 回目の失敗には、HTTP 503 のほかに、10 秒でタイムアウトするなど応答を受け取れなかったリクエストが含まれます。
2 回目は、負荷をピークの約 1.8 倍まで上げた時点で終了しました。実行全体の集計で p95 338 ms、失敗率 0.04% と、設定した基準(p95 < 1.5 秒、失敗率 < 1%)を満たし、HTTP 503 は発生しませんでした。この試験をしていなければ、切り替え後のピーク時間帯に起こりうる障害を、本番で初めて知ることになっていたはずです。
4. wildcard alias を経由した無停止の切り替え
本番は、CloudFront が「Host と alias の一致」で distribution を選ぶことを利用して、停止 0 で切り替えました。
今回のアカウント間の移行で停止が発生する理由
- CloudFront の alias(CNAME)は 1 つの distribution にしか付けられない
- DNS がその名前を別の distribution に向けている間は、alias の追加自体が拒否される
- alias を distribution 間で移す API(
associate-alias)は、AWS アカウントをまたぐ場合、移動元を先に無効化する必要がある
旧 distribution は別アカウントにあったので、素直にやると切り替えの間サイトが止まります。実際、dev と stg ではそれぞれ 8〜9 分の停止を許容して切り替えました。
wildcard を経由する
AWS のドキュメントにある、wildcard を使って代替ドメイン名を移す手順を使いました(代替ドメイン名を移動する、代替ドメイン名でワイルドカードを使用する)。ポイントは、完全一致の alias が wildcard より優先されることです。
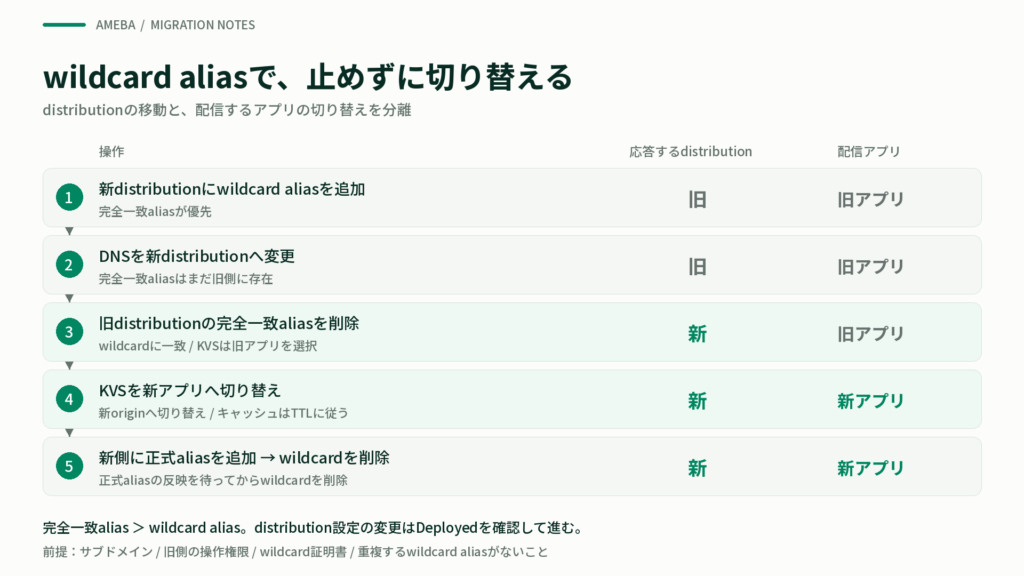
| 手順 | 作業 | 応答している distribution |
|---|---|---|
| 1 | 新 distribution に一時的な wildcard alias を追加 | 旧(完全一致の alias が旧にある) |
| 2 | DNS を新 distribution へ向ける | 旧(alias はまだ旧にある) |
| 3 | 旧 distribution から alias を外す | 新(wildcard に一致)。KVS は旧のままなので中身は旧アプリ |
| 4 | KVS の値を新アプリに | 新 → 新アプリ |
| 5 | 新 distribution に正式な alias を付け、wildcard を外す | 新 |
- 各ステップで Deployed を待ってから次に進んだ
- 切り替え中もトップページは 200 のまま
- wildcard が付いている間に他のサブドメインの Host が届いても、CloudFront Function の host チェックが 404 を返すので安全
この手順には前提があります。apex ドメインには使えず、移動元の distribution の alias を操作できる権限と、wildcard を覆う証明書が必要です。また、重なる wildcard の alias をほかの distribution がすでに使っていないことも条件です。今回はサブドメインで、*.ameba.jp の証明書があったので使えました。
実質の切り替え(手順 3〜4)は 5 分ほどです。切り替え後、全ページで PC / SP ともに 200、応答が新アプリから返り、キャッシュも Hit していることを確認しました。
残っていること
トラフィックの切り替えは完了しましたが、安定化と旧環境の廃止が残っています。
- 1〜2 週間ほど様子を見て、安定化を判断する
- TTL を段階的に旧アプリ相当まで延ばす
- KVS と rollback の仕組みを削除する(ここから先は旧アプリに戻せない)
- 旧アプリの CloudFront・Elastic Beanstalk・CI の job などを廃止する
おわりに
今回の移行で難しかったのは、作り直すことそのものよりも、「何を確認できれば切り替えてよいと言えるか」を決めることでした。旧アプリと同じであるべきところ、意図して変えるところ、まだ確認できていないところを整理し、チームで判断できる形にしていきました。それが、コピーではなく翻訳するということだったのだと思います。
配属から半年弱、途中で担当サービスが変わる中での移行でしたが、最後に本番を一度で、止めずに切り替えられたことにほっとしています。
レビューや相談に乗ってくださったチームの皆さん、ありがとうございました。同じようにレガシーな構成の移行を控えている方の参考になればうれしいです。