

はじめに
こんにちは 🐈
東京工科大学 学部3年の広瀬 エイトル(@Heitor_Hirose)です。
今年の夏、大学の休みのほとんどを利用して2026年8月から1.5ヶ月間、AI POSチームのミッション型インターンシップに参加しました。実は、AI POSでのミッション型インターンシップは2回目で、前回はLLMの動きを観測する基盤としてLangfuseを構築しました。そのときの話は前回の記事にありますので、興味があればぜひ一読していただけると嬉しいです!🙌
今回のミッションは、AI POSのエージェントがサイバーエージェント社員の知識や顧客企業の社内知識を参照して答えられるようにする基盤を考案、構築することでした。
プロダクト概要
私がインターン生として参加したプロダクトは 「AI POS(エーアイポス)」です。小売業界の現場が抱える膨大かつ複雑な POS(販売時点情報)データを、生成AI技術を用いて “誰もが使える形” に変える分析ツールです。
売上や前年対比、店舗別・商品別の傾向などを、人手による集計や専門ツールなしで、手軽にレポートとして受け取り、データに基づくビジネスの意思決定を素早く行えるようにします!
https://www.cyberagent.co.jp/service/dx/aipos/
エージェントの構成
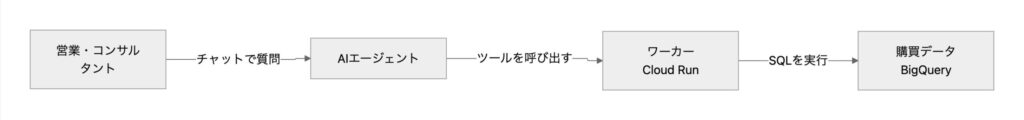
現在のAI POSでは、営業やコンサルタントがチャットで質問すると、AIエージェントがSQLを組み立てて購買データを集計し、メーカーへの提案に使える形で返してくれます。
後の設計に関わる前提が2つあると考えました。1つは、顧客企業ごとのデータや知識を混ぜないことです。もう1つは、エージェントが直接データベースに触れるのではなく、Cloud Run上のワーカーが実行するツールを通して操作することです。
課題と要件
エージェントはSQLを書くのも集計するのも得意ですが、LLMが答えられるのはモデルで学習できている一般的な知識までです。その小売がどんな方針で売り場を作っているか、社内で指標をどう定義しているかを知っていることはほとんどありません。
これまでは、担当者がSlackなどで共有した知見を、エンジニアがエージェントのプロンプトに反映していました。業務固有の用語や指標の定義を継続的に反映し、解釈の一貫性を高めることと、知識を更新するたびに生じるエンジニアの作業を減らすことが課題でした。
そこで、作る基盤の要件を次の4つに置きました。以降の技術選定は、この4つを基準にしています。
- エンジニアでなくても知識を書ける
- 知識の書き方がそろっている
- 顧客企業ごとに知識を分離できる
- エージェントが検索して引ける
このプロジェクトでの「知識」
ここでの「知識」は一般的な定義ではありません。どのような内容をこの基盤で管理するのか線引きのために、私が今回のインターンに合わせて定義したものです。
私は知識を 「特定の状況で使うべき解釈や判断を、再利用できる形で言語化したもの」 としました。事実との違いは次のとおりです。
例として下記のようなイメージです。
知識:セール期間の売上の伸びは、前年の同じ時期の伸びを差し引いて評価する
事実:昨年度の売上は〇〇円だった
事実はデータを引けばある程度分かりますが、それをどう解釈するかはデータだけでは決まりません。そのため、この基盤では知識だけを扱うことにしました。
たとえばリピーター客を定義する場合においてでも、「2回以上来店した会員」と「同じカテゴリを2回以上買った会員」では人数が変わります。どちらを使うかを書き残し、エージェントが毎回同じ定義で答えられるようにすることが、今回の基盤の目的です。
チームでは、知識を共有する範囲で3つの層に分けています。
個人の知識:
その人の作業の中だけで使う。エージェントのメモリー機能が受け持つので、今回は対象外
小売の知識:
その小売を担当するチームで共有する。他の顧客企業から見えてはいけない
プロダクト全体の知識:
顧客企業様固有情報を含まず、共有可能と確認した一般的な指標の定義や分析の考え方などを、共通して使う対象とします。
今回は小売の知識とプロダクト全体の知識の2つを対象にしました。この見え方の違いが、後で書く権限の設計につながります。
技術の選定
なぜいま知識の基盤なのか
最近のエージェント開発では、プロンプトの書き方よりも「エージェントに何をどれだけ渡すか」が重視されるようになってきています。Anthropicはこれをコンテキストエンジニアリングとして整理していて、指標の定義をAIとBIの間でそろえるOpen Semantic Interchangeのような取り組みも始まっています。※1 ※2
Google Cloudも2026年4月にDataplex Universal CatalogをKnowledge Catalogに改名しており、エージェントに文脈を渡す基盤として開発されています。こうした流れもあり、知識をエージェントに渡す基盤は、今まさに求められているものだと感じています。※3 ※4
※1 Effective context engineering for AI agents – Anthropic
※2 Open Semantic Interchange – Snowflake
※3 Knowledge Catalog release notes
※4 Introducing the Google Cloud Knowledge Catalog
知識の形式にOKFを選んだ理由
知識の形式には、Googleが公開しているOpen Knowledge Format(以下OKF)を採用しました。※5
OKFは、YAMLのfrontmatterを付けたMarkdownファイル1つを、1件の知識として扱う形式です。2026年7月に公開されたv0.2では、知識の出典、誰がいつ確認したか、いつまで有効か、下書きか確定かといった、知識を信頼してよいか判断するための項目が加わりました。 ※6
採用した理由は2つあります。
1つ目は、Googleが開発している形式であることです。保存先に選んだKnowledge Catalogも同じGoogle Cloudの製品で、OKFをKnowledge Catalogに取り込む手順もGoogleが公開しています。※9 形式と保存先を同じ開発元でそろえられるので、今後の機能追加にも追従しやすいと考えました。
2つ目は、知識どうしの関係を表現できることです。OKFでは知識1件ごとに指標や用語、計算方法といった種類を持たせ、本文からほかの知識へリンクを張れます。そのため、知識をバラバラのメモとしてではなく、概念どうしのつながり、いわゆるオントロジーとして扱えます。
また、OKFはただのMarkdownファイルなので、編集画面や保存先を後から替えても知識そのものは移し替えられます。
この形式を使うことを先にチームで合意したので、要件の2も満たせます。
※5 GoogleCloudPlatform/open-knowledge-format
※6 OKF v0.2 adds trust signals
※9 Scale OKF bundles across an organization with Knowledge Catalog
保存先にKnowledge Catalogを選んだ理由
保存先にはKnowledge Catalogを選びました。決め手は2つあります。
1つ目は、BigQueryのテーブル情報と同じ場所に置けることです。テーブルや列の説明はデータインサイトで生成して公開するとKnowledge Catalogに保存され、検索の対象になります。そのため、エージェントは「どのテーブルを使うか」と「そのテーブルをどう解釈するか」を同じAPIで引けます。※7
2つ目は、権限をGoogle CloudのIAMで管理できることです。IAMで知識を分けられるので、要件の3にも対応できます。
OKFの知識は、Knowledge Catalogのカスタムエントリ ※8 として登録します。Googleのブログ記事 ※9 の手順どおり、知識1件ごとに1つのentryができ、本文を持つoverviewと、OKFの出典や状態を持つokfの2つのaspectが付きます。entryはentry groupにまとめ、entryの種類をentry type、aspectの型をaspect typeとして定義します。
※7 Data insights
※8 Ingest custom sources
※9 Scale OKF bundles across an organization with Knowledge Catalog
編集画面にochakaiを使った理由
ochakai※11は、個人の方が開発しているMITライセンスのOSSで、OKFの知識を保存して管理するナレッジサーバーです。Web画面・REST API・CLI・MCPから知識を読み書きでき、変更はすべて履歴として残り、知識全体をOKFのファイルとして書き出せます。
ちなみに、ochakaiを開発している方が勤めている会社には、私も以前インターンでお世話になったことがあります。
このochakaiを編集画面に使ったのは、Knowledge Catalogの画面に次のような問題があったからです。
カスタムエントリをコンソールから作れない:
公式ドキュメントにあるとおり、作成はAPIかCLIで行う必要があります ※8
入れ子の項目を画面から編集できない:
入れ子の項目を持つaspectは、コンソールでの編集がサポートされていません ※10
全体像をつかみにくい:
本文のMarkdownは整形されずに表示され、知識の階層もentryのIDをスラッシュで区切って表すだけです
これでは、エンジニアでない人に「ここに書いてください」とはお願いできず、要件の1を満たせません。
そこで、ブラウザからOKFを編集できるochakaiを、編集の入口として一時的に導入しました。自分たちで編集画面を作ると時間がかかりますが、ochakaiならブラウザから編集できる仕組みをすぐに用意できます。
ただし、今回使っているのは**「Web画面でOKFを編集できること」と「OKFとして書き出せること」**の2点が大きいです。ochakaiの検索やMCPといった機能には依存しないような形にしました。いずれはチーム内で話し合ったうえで独自の管理機構に移す予定ですが、そのときもOKFのファイルを移すだけで済むので、一時的に採用しても問題ないと考えました。
※8 Ingest custom sources
※10 Enrich entries with metadata
※11 ochakai – データエージェントのためのナレッジ&コンテキストレイヤー
アーキテクチャ設計・構築
全体像
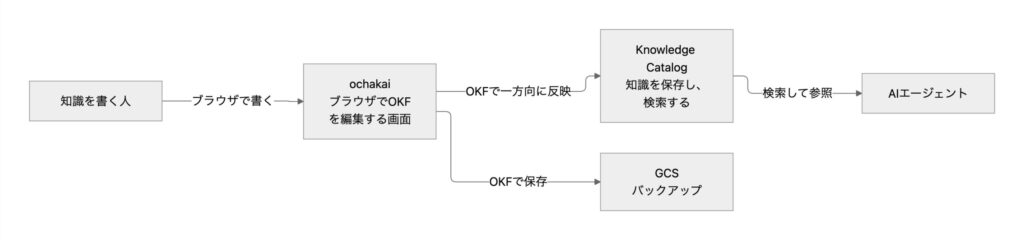
知識はochakaiからKnowledge Catalogへ一方向に流し、エージェントはKnowledge Catalogだけを見るようにしました。一方向にしたのは、編集の入口を差し替えてもエージェント側に影響が出ないようにするためです。登録は日次のジョブで行う設計にしていて、インターン期間中は自作のCLIで手動の登録と並行して整えました。
Knowledge Catalogの権限モデル
一番時間をかけたのが権限の設計です。保存先の節で書いたとおり、知識1件は1つのentryになり、entryはGCPプロジェクトの中のentry groupにまとめられます。素直に考えると、entry groupごとに権限を分ければ知識も分けられそうに見えます。
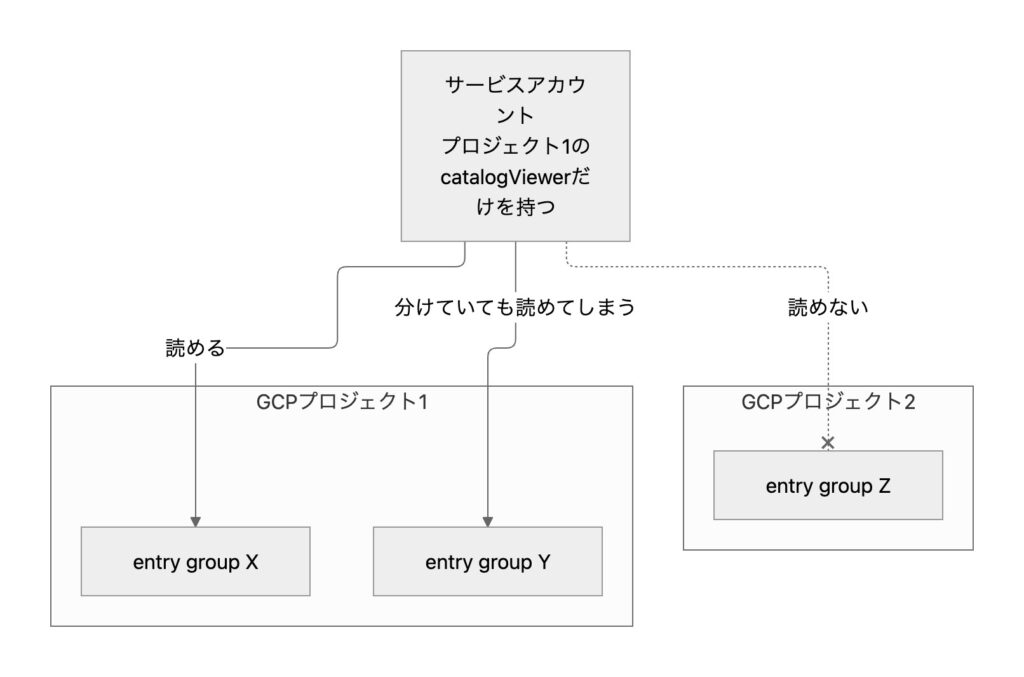
しかし、Knowledge Catalogのカスタムエントリは、entry groupごとに権限を分けるだけでは分離できません。 カスタムエントリが検索で見えるかどうかはプロジェクトに付与するroles/dataplex.catalogViewerで決まり、このロールを持つ相手には、同じプロジェクトにあるすべてのentry groupの知識が見えてしまうからです。以下、このロールをcatalogViewerと書きます。
根拠にした仕様は次の3つです。
entry単位ではIAMを設定できない:
IAMロールのページ※13の付与対象はentry groupやentry typeまでで、entriesのAPI※14にもIAMを設定する操作がありません。アクセス制御のページ※12には付与の対象としてentriesも挙がっていますが、entryは所属するentry groupの権限を引き継ぎます。OKFのブログ記事※9にも”inherit IAM from the EntryGroup”と書かれています
カスタムエントリの検索結果はプロジェクトのロールで絞られる:
検索のドキュメント※15によると、カスタムエントリは、検索に使うプロジェクトのcatalogViewerを持っていれば見えます。BigQueryのテーブルに対応するエントリが、元のテーブルかデータセットのroles/bigquery.metadataViewerで絞られるのとは異なります
検索範囲を省くと組織全体が対象になる:
searchEntries※16のscopeはプロジェクトか組織を指定する項目で、指定しないと、呼び出したプロジェクトが属する組織全体が対象になります
1つ目と2つ目から、カスタムエントリを読める相手は実質的にGCPプロジェクト単位で決まります。3つ目から、検索範囲も明示的に固定しないと広がってしまいます。そのため、読める相手を分けたい知識は別のGCPプロジェクトに置き、検索範囲はワーカー側で固定する必要があります。置き分け方は次の節で、検索範囲の固定は「エージェントから知識を引くツール」の節で書きます。
※9 Scale OKF bundles across an organization with Knowledge Catalog
※12 IAM and access control
※13 IAM roles
※14 REST Resource: projects.locations.entryGroups.entries
※15 Search for assets
※16 Method: projects.locations.searchEntries
GCPプロジェクトをまたいで知識を分けるとき
複数の相手で共有したい知識は、それぞれがcatalogViewerを持つプロジェクトに置けば共有できます。その場合は、そのプロジェクトを読めるすべての相手から読まれる前提で扱います。
次の図は、GCPプロジェクト1のcatalogViewerだけを持つサービスアカウントから、どのentry groupが見えるかを示したイメージです。
プロジェクトをまたいで置いた知識をエージェントに検索させる場合、エージェントのサービスアカウントには次の権限が必要です。
| 付与先 | ロール | 目的 |
|---|---|---|
| 読ませたい知識を置いた各プロジェクト | roles/dataplex.catalogViewer |
そのプロジェクトの知識を検索・参照する |
| 検索対象にするデータセット | roles/bigquery.metadataViewer |
テーブルのエントリを検索結果に出す |
2つ目は特に見落としやすいポイントです。metadataViewerが無くてもエラーにはならず、検索結果が0件になるだけなので、権限不足だと気づきにくいです。
また、検索クエリの条件は境界になりません。 クエリの中でparent:などを使って対象を絞ることはできますが、エージェントがクエリにORを足すと、条件の外まで結果が広がることを実際に確認しました。境界はIAMと、次に書く検索範囲の固定で作る必要があります。
エージェントから知識を引くツール
エージェントに渡す知識検索用のツールはknowledge_retrievalの1本だけにしました。モデルが指定できるのは検索語と件数だけで、どこを検索するかはワーカー側の設定で固定しています。scopeを省くと組織全体が対象になってしまうので、ここをモデルに任せると、それだけで分離が崩れてしまうからです。
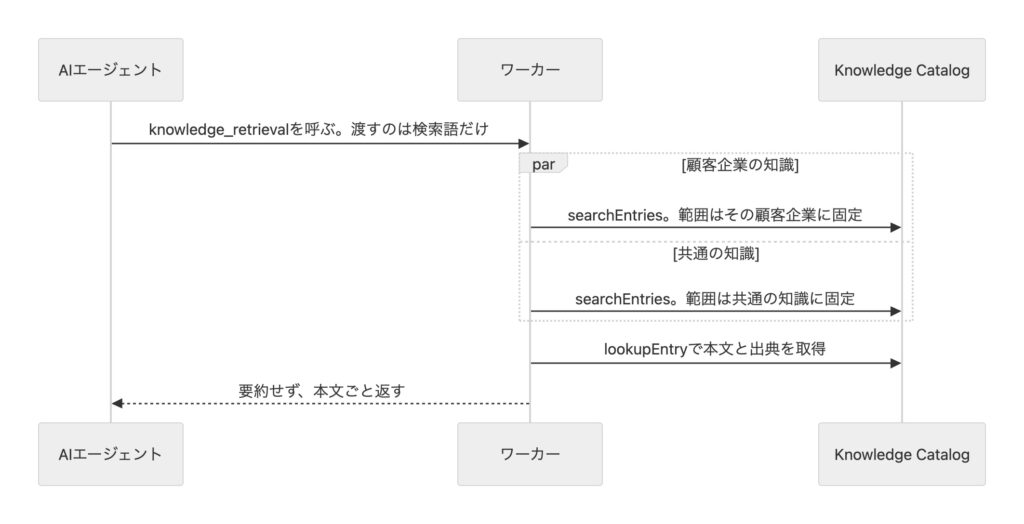
検索では、クエリにOKFのaspectの条件を加えて、知識以外のエントリを除いています。本文はlookupEntryで取り直します。エージェント向けに整形した文脈を返すlookupContextもありますが使用しませんでした。※17
※9 Scale OKF bundles across an organization with Knowledge Catalog
※17 Retrieve data context
そのほかつまずいたこと
Knowledge Catalogは2026年4月に改名されたばかりで、日本語のドキュメントや解説記事はまだ多くありません。そのため、仕様の確認は英語の公式ドキュメントやGoogle Cloudのブログを主軸に進めました。
加えて、Knowledge CatalogやOKFを使った日本での採用事例は、調べた範囲では公にはあまり見つかりませんでした。設計を決めるときに参考にできる先行事例が少なく、仕様を読んでは実際に試す、という進め方になりました。この記事が、同じように検討している方の参考になれば嬉しいです。
Knowledge Catalogの検索性能について
作ってみて一番困ったのが、Knowledge Catalogの検索性能です。ここでは、ドキュメントに書かれている仕様と、実際に試した結果を分けて書きます。
ドキュメントに書かれていること
Knowledge Catalogの検索には、クエリの意味を解釈するsemantic検索と、キーワード検索の2つがあります。ドキュメントには”supports both semantic and keyword matching”とあり、キーワードだけの検索は後方互換のためのモードという扱いです。※18 APIではsearchEntriesのsemanticSearchで切り替えます。※16
キーワード検索では、名前は部分一致、説明文はトークン単位の一致で照合されます。aspectの中で検索に使えるのはトップレベルの項目だけだと検索構文のドキュメントに書かれています。※1
一方で、日本語など英語以外の言語で検索したときの挙動は、検索に関するドキュメントには見当たりませんでした。また、検索は該当するものをすべて返すことを保証しておらず、同じクエリでも結果が変わりうると明記されています。
※3 Knowledge Catalog release notes
※16 Method: projects.locations.searchEntries
※18 About search
※19 Search syntax
試して分かったこと
開発環境で検索範囲を1つに固定し、同じ語をキーワード検索とsemantic検索で比べてみました。
キーワード検索:
知識を書いた人と同じ語を使えば当たりますが、表記の揺れや動詞の活用が違うだけで0件になりました。自然な言い回しで質問した場合も同じです。また、今回の環境で自動生成したテーブルの説明は英語だったため、英語では見つかるテーブルが、同じ意味の日本語では見つかりませんでした
semantic検索:
表記の揺れや活用の違いには強くなります。その代わり、該当する知識が無い質問でも何かしらを返し、関係のないものが上位に来ることがありました
検索は自前で用意する必要がありそう
知識の保存先としてのKnowledge Catalogには個人的に満足していますが、今の検索性能では、エージェントが必要な知識を安定して引くのは難しいと感じています。そのため、Knowledge Catalogとエージェントの間に、知識検索用のサービスを自前で用意していく必要がありそうです。
今後の課題
検索サービスの整備:
Knowledge Catalogの検索だけでは、表記の揺れや言い換えで必要な知識が引けなかったり、関係のない知識が返ってきたりします。日本語の業務用語で引けて、該当する知識が無いときは無いと返せる検索サービスを用意するのが、一番大きな課題です
知識の自動投入:
エージェントの作業記録から知識の候補を起こして人が確認する流れを作り、手で書くだけに頼らない状態を目指します
独自の編集画面への移行:
「今はochakaiを一時的に使っているので、エンジニアでない人も書きやすい独自の編集画面へ移す必要があります
登録済みの知識の見直し:
独自の言い回しや用語のずれ、特定の人の知見への偏りがあり、見直しが必要です
まとめ
今回の基盤づくりで得た学びは3つです。
- 保存先より前に形式を決めることで、ツールの選択を後から変えられる判断にできた
- Knowledge Catalogのカスタムエントリで読める相手を分けるなら、entry groupではなくGCPプロジェクトの境界で分け、検索範囲も固定する必要がある
- 知識の保存先と検索は分けて考えるべきで、検索には専用の仕組みが必要
最後に
今回はAI POSでの2回目のインターンでしたが、過去の自分と比べてすごく成長を実感できました!
去年は進め方に迷う場面が多く、計画を立ててもなかなかそのとおりに進められませんでした。今回は事前に「この期間だとここまでは間に合わないから、スコープをここで切っておこう」「ここはあの人の協力が必要だから、先に相談しておこう」と考えて動けたので、計画どおりに進められた場面が多かったと思います。
課題が明確だったことも大きかったです。去年は途中で「そもそも何をやればいいんだっけ」と迷うことが多かったのですが、今回は課題を整理したうえで、迷ったときには何が足りていないのか、どうすればいいのかを考えてから動けました。
そして何より、自分から主体的に動けたことが一番の成長だと感じています。必要だと思えば自分から1on1を組んだり、関係する方に相談しに行ったりと、指示を待たずに動くことを意識していました。
また、Knowledge Catalogは今年の4月に今の形になったばかりのサービスで、なかなか試せる機会がありません。それを自分の手で試しながら設計できたのは、とても良い機会だったと思います。
2回目のインターンも温かく迎えてくださったAI POSチームの皆さん、本当にありがとうございました!🙏
最終発表で使った資料も載せておきます。