

はじめに
株式会社 AJA の DSP チームにて、2026 年 7 月より約 2 ヶ月間、内定者アルバイトをしていた 27 卒パブリッククラウド内定者の杉原充稀(@mitsu3s_)です。
本記事では、内定者アルバイト期間中に取り組んだ、AJA DSP を構成するマイクロサービスにおけるオブザーバビリティ強化の施策について紹介します。
分散トレーシングの必要性
AJA DSP の広告配信基盤では、複数のマイクロサービスが連携して、SSP から届いた入札リクエストに対して、広告候補の取得、配信条件の判定、予算の確認などを行い、短い期限の中で入札結果を返します。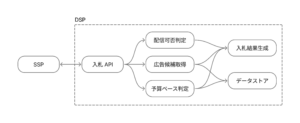 上記の構成は単純化したものですが、一つのリクエストが複数の内部サービスやデータストアを横断します。
これまで、この広告配信基盤には、サービスを横断して一連の処理を確認できるトレーシング基盤がありませんでした。メトリクスから異常を検知し、各サービスのログを使って原因を調査することはできましたが、一つのリクエストがどのサービスを通り、どこで時間を使い、どこで失敗したのかを追うには、複数の画面やログを行き来する必要がありました。
そこで、OpenTelemetry による計装と、OpenTelemetry Collector を活用した Tail-based Sampling 基盤を導入しました。
Tail-based Sampling の選定理由
広告配信基盤には大量のリクエストが流れます。すべての Trace を Datadog へ保存すると、保存量とコストが大きくなります。
処理開始時に保存可否を決める Head-based Sampling では、そのリクエストがエラーになるか、遅くなるかを判断できません。低い確率でサンプリングすると、調査したい異常な Trace まで失う可能性があります。
Tail-based Sampling では、 Trace が完了するまで一時的に保持し、結果を確認してから保存可否を決めます。これにより、エラーなどの調査価値が高い Trace は確実に残しながら、正常な Trace は必要な割合だけ保存できます。ただし、保存しない Trace も、判断が終わるまでは Collector へ届きます。そのため、Datadog へ送る量だけでなく、サンプリング前の全 Span を処理できる構成が必要になります。
DDOT と OpenTelemetry Collector による二層構成
採用した構成は次の通りです。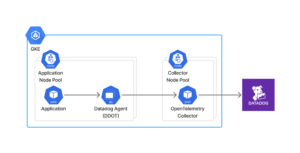
Datadog Distribution of OpenTelemetry Collector(DDOT) は、各ノードでアプリケーションから Span を受け取り、Trace ID を基準にサンプリング処理をする Collector へ振り分けます。
Tail-based Sampling では、一つの Trace に含まれるすべての Span を同じ Collector へ集める必要があります。通常の Kubernetes Service による分散では、同じ Trace の Span が複数の Collector に分かれる可能性があります。そのため、DDOT の Load Balancing Exporter を利用しました。
以下は構成を簡略化した例です。
exporters:
  load_balancing:
    routing_key: traceID

    retry_on_failure:
      enabled: true

    sending_queue:
      enabled: true

    protocol:
      otlp:
        retry_on_failure:
          enabled: false
        sending_queue:
          enabled: false

    resolver:
      k8s:
        service: <collector-service>.<namespace>
        ports:
          - 4317
DDOT を Collector 群として構築する案もありましたが、その役割は受信と振り分けに限定できます。そこで、各ノードで DaemonSet として動く DDOT を利用し、 Trace の保持とサンプリングを行う Collector だけを専用のノードプールに配置しました。
Collector は Trace の保持によるメモリ使用と、サンプリングルールの評価による CPU 使用に偏りがあります。アプリケーションと同じノードプールに配置すると、広告配信処理とリソースを奪い合う可能性があるため、ノードプールを分離しています。
調査価値に基づく Sampling Policy
当初は、エラーになった Trace を全件保存し、正常な Trace を低い割合で保存する方針から始めました。しかし、本番の Trace を確認すると、Span Status が ERROR かどうかだけでは調査価値を判断できないことが分かりました。
そこで、HTTP Status や Span Status だけでは表現できない状態については、処理結果や劣化状態を示す属性(Attribute)をアプリケーション側で付与しました。現在は、障害調査だけでなく、応札状況の変化や配信処理の最適化にも利用できるよう、処理の意味に応じて保持率を変えています。
| 対象 | 保持方針 |
|---|---|
| システム側の処理失敗 | 全量保持 |
| 原因と判定できる下流エラー | 全量保持 |
| 非同期処理の送信失敗 | 全量保持 |
| フォールバックによる品質低下 | 全量保持 |
| 入力異常 | 全量保持 |
| キャンセルやその他の 4xx | 一部保持 |
| 応答期限に近い処理 | 通常系より高い割合で保持 |
| 業務上重要な正常処理 | 通常系より高い割合で保持 |
| 一般的な正常処理 | 少量保持 |
| 成功した機械的な非同期処理 | ごく少量保持 |
実際のルールは複数の条件を組み合わせていますが、基本的な構造だけを抜き出すと次のようになります。
processors:
  tail_sampling:
    decision_wait: 10s
    sample_on_first_match: true

    policies:
      # エラーを含むトレースは保持する
      - name: errors
        type: status_code
        status_code:
          status_codes:
            - ERROR

      # 上の条件に一致しないトレースから少量を保持する
      - name: baseline
        type: probabilistic
        probabilistic:
          sampling_percentage: 0.1
本番適用後に直面した問題への対処
サンプリングルールの評価による CPU の過度な消費
本番データを確認しながら保存条件を追加した結果、サンプリングポリシーは一時 20 個まで増えました。ポリシーが多いこと自体が問題ではなく、今回の構成では、保持率が同じ条件を別々のポリシーとして定義し、それぞれが同じ Trace 内の Span を走査していたことが CPU 負荷につながりました。
以下は評価方法を説明するための例です。条件名と保持率は実際の設定とは異なります。変更前は、条件 A と条件 B を同じ割合で保存する場合でも、別々のポリシーとして評価していました。
tail_sampling:
  policies:
    - name: condition-a-sample
      type: and
      and:
        and_sub_policy:
          # すべてのトレースから条件 A を探す
          - name: condition-a
            type: ottl_condition
            ottl_condition:
              span:
                - span.attributes["example.category"] == "A"

          - name: sampling
            type: probabilistic
            probabilistic:
              sampling_percentage: 10

    - name: condition-b-sample
      type: and
      and:
        and_sub_policy:
          # 同じトレースをもう一度走査して条件 B を探す
          - name: condition-b
            type: ottl_condition
            ottl_condition:
              span:
                - span.attributes["example.category"] == "B"

          - name: sampling
            type: probabilistic
            probabilistic:
              sampling_percentage: 10
この構成では、最終的に 10% しか保存しない場合でも、すべての Trace に対して条件 A と条件 B の評価が行われます。変更後は、保持率が同じ条件を一つのポリシーへまとめました。また、安価な確率判定を先に実行し、対象になった Trace だけを OTTL で詳しく評価するようにしています。
tail_sampling:
  # ポリシーを優先度順に評価し、保存が決まった時点で後続の評価を終了する
  sample_on_first_match: true

  policies:
    - name: grouped-sample
      type: and
      and:
        and_sub_policy:
          # 先に保存候補を絞る
          - name: sampling-first
            type: probabilistic
            probabilistic:
              sampling_percentage: 10

          # 候補になったトレースだけを走査する
          - name: grouped-condition
            type: ottl_condition
            ottl_condition:
              span:
                - span.attributes["example.category"] == "A"
                - span.attributes["example.category"] == "B"
例えば 100 万件の Trace が届いた場合、変更前は条件 A と条件 B のために、それぞれ最大 100 万件を評価します。変更後は、先に 10% へ絞ったうえで、最大 10 万件を一度走査します。実際の設定では、全件保存する条件、同じ割合で保存する調査条件、通常系の条件をそれぞれ集約しました。さらに、保存条件に一致した時点で後続ポリシーの評価を終了することで、保持条件を変えずに 20 個のポリシーを 7 個まで削減しています。
Collector のスケールダウン時に Trace を失わないための設計
トラフィックが落ち着き、Collector がスケールダウンする際には、DDOT と Collector の二か所に未処理のデータが残ります。DDOT では、未送信 Span が終了する Collector へ再送し続ける問題があり、Collector では、判定待ちの Trace を持ちながら即座に Pod が終了する課題がありました。
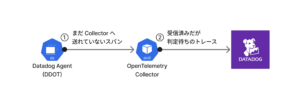
DDOT の送信キューを共通化する
DDOT は、Trace ID を使って送信先 Collector を決めています。例えば下図のように、送信先ごとにキューを持つ構成では、一度 Collector C 向けのキューに入った Span は、C が終了しても C への再送を続けます。そこで、送信先を決める前の共通キューだけを利用する構成に変更しました。
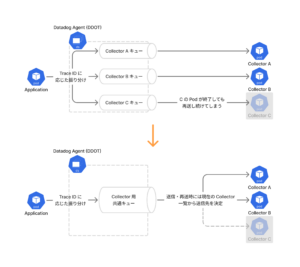 設定の要点は、Load Balancing Exporter 全体でキューと再送を持ち、送信先ごとの OTLP Exporter には持たせないことです。再送時には最新の Collector 一覧から送信先を選び直すため、終了した Collector に固定されず、稼働中の Collector へ送信できます。
exporters:
  load_balancing:
    # 送信先を決める前の共通キュー
    sending_queue:
      enabled: true
    retry_on_failure:
      enabled: true

    protocol:
      otlp:
        # 送信先ごとのキューは作らない
        sending_queue:
          enabled: false
        retry_on_failure:
          enabled: false
Collector の判定待ちトレースを終了前に処理する
DDOT から送信済みの Span は、Collector の Tail-based Sampling Processor で Trace 単位に保持されています。Collector Pod がすぐに終了すると、判定待ちバッファに残っている Trace を処理できません。そのため、Pod の終了前に待機時間を設けています。
terminationGracePeriodSeconds: 60

lifecycleHooks:
  preStop:
    sleep:
      seconds: 30
Collector が終了状態になると、DDOT の送信先一覧から対象 Pod が外れます。一方、Collector のプロセスは待機時間中も動作するため、すでに受信していた Trace の判定と送信を継続できます。
DDOT では、まだ Collector へ届いていない Span を再振り分けし、Collector ではすでに届いている Trace を終了前に処理します。この二つを組み合わせることで、スケールダウン時の欠損を抑えています。
導入後の状態
分散トレーシングの導入により、これまでサービスごとのログを追っていた処理を、Datadog 上で一つの Trace として追跡できるようになりました。
本番トラフィックでもサンプリングルールは意図した通り機能しています。5xx や処理失敗、処理品質の低下、非同期処理の失敗を含む Trace は全体が保存され、遅延、キャンセル、4xx、正常な処理もそれぞれ定めた割合で保存されています。
下記は、Datadog 上でエラー Trace を表示した例です。入口から下流サービスやデータストアまでの処理経路に加え、エラー箇所や各処理にかかった時間を一つの画面で追跡できます。
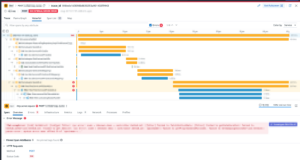
処理結果やエラー原因を示す属性も Datadog まで引き継がれており、同じ HTTP Status でも内部の処理結果を区別できます。正常な Trace も処理結果やレイテンシに応じて残しているため、障害調査だけでなく、性能調査や配信状況の分析にも利用できます。
本番適用後も、アプリケーションのレイテンシやエラー率、応札処理に顕著な悪化は発生していません。Collector のリソースとサンプリングポリシーを調整することで、ピーク帯のトラフィックを処理しながら、想定していた予算帯での運用を実現しています。
まとめ
本記事では、高トラフィックな広告配信基盤へ Tail-based Sampling を導入するために、DDOT と OpenTelemetry Collector による二層構成を採用し、調査価値に応じて Trace を保存する仕組みを紹介しました。
本番運用では、サンプリングポリシーの評価による CPU 負荷と、Collector のスケールダウン時における Span の欠損が発生しました。保存条件と保持率を維持したままポリシーを集約し、DDOT のキュー構成と Collector の終了処理を見直すことで対応しています。
Tail-based Sampling は、Collector を配置してエラーを保存するだけでは完結しません。どの Trace に調査価値があるのかを本番データから判断し、サンプリング前の生成量や Collector の縮退まで含めて設計できたため、より効果的な分散トレーシング基盤になったと考えています。
最後までお読みいただき、ありがとうございました。