

はじめに
こんにちは。Re:Career採用で26新卒としてABEMAに入社し、広告配信システムの開発チームでバックエンドエンジニアをしている阿部 (@ryuya17a)です。
先日、広告配信システムのあるコンポーネントが本番環境でメモリ上限に達し、OOMKillされ続ける問題が発生しました。調査した結果、原因は社内共通ライブラリが patrickmn/go-cache をラップしている箇所にあり、修正はポインタのデリファレンス * を1文字付け替えるだけでした。
キャッシュとしては正常に読み書きできているのに、裏ではメモリが解放されなくなっていました。その正体は、runtime.SetFinalizer を使ったライブラリ独自の寿命管理と、値コピーの組み合わせで起きるメモリリークでした。同じ構造のバグは他のGoコードベースでも起こり得るため、メトリクスによる切り分けから原因リリースの特定、コードリーディング、再現テストによる実証まで、調査の過程を順に紹介します。最後に、この設計を今のGoの視点で振り返ります。
背景
問題が起きたのは、広告キャンペーンが配信期間内に過不足なく配信されるよう、配信目標を定期的に計算して配信量を制御するコンポーネントです。広告キャンペーンには配信期間と目標配信量があり、それを期間内に達成するために、時間粒度ごとの配信目標を計算し続ける必要があります。このコンポーネントは長時間動き続ける単一のプロセスで、2分ごとに定期処理を実行し、その計算結果をインメモリキャッシュに書き込みます。
きっかけは、本番のメモリ使用量のグラフに違和感を覚えたことでした。メモリ使用量が右肩上がりに増え続けている一方で、ところどころ一時的に下がっている箇所がありました。調べてみると下がるタイミングはすべてデプロイの時刻と一致していました。デプロイでPodが入れ替わるとメモリ使用量がリセットされ、また同じ傾きで増えていく現象から、インメモリキャッシュが溜まり続けているのではないかと仮説を立てました。
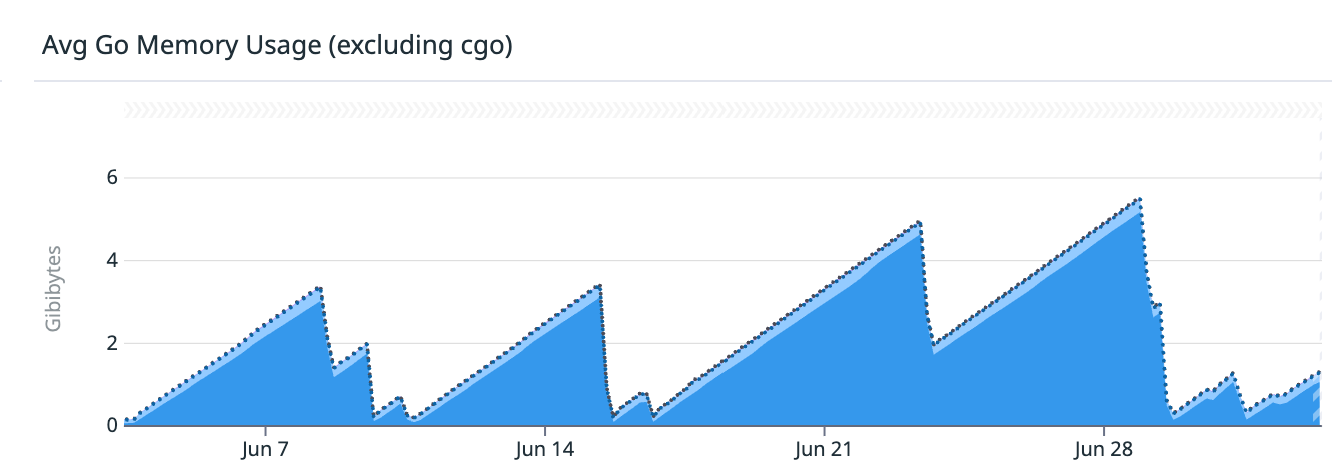
この問題には、気づきにくい条件がそろっていました。デプロイが頻繁な時期は、そのたびにメモリがリセットされるため異常として現れません。また、このコンポーネントは視聴者の広告リクエストのパスには乗らず、その裏で配信目標を計算して渡しているので、OOMKillで再起動を繰り返しても、ユーザー向けのレイテンシやエラーレートには何も現れません。再起動のあいだ配信目標の更新が数分止まるだけで、配信そのものは直前の値で動き続けます。デプロイ間隔が空いたことでメモリが8GiBのリミットに到達し、OOMKillと再起動を繰り返すようになって、ようやく顕在化しました。
ここからは、この「インメモリキャッシュが溜まり続けている」という仮説を、メトリクスで調べていきます。
メトリクスによる切り分け
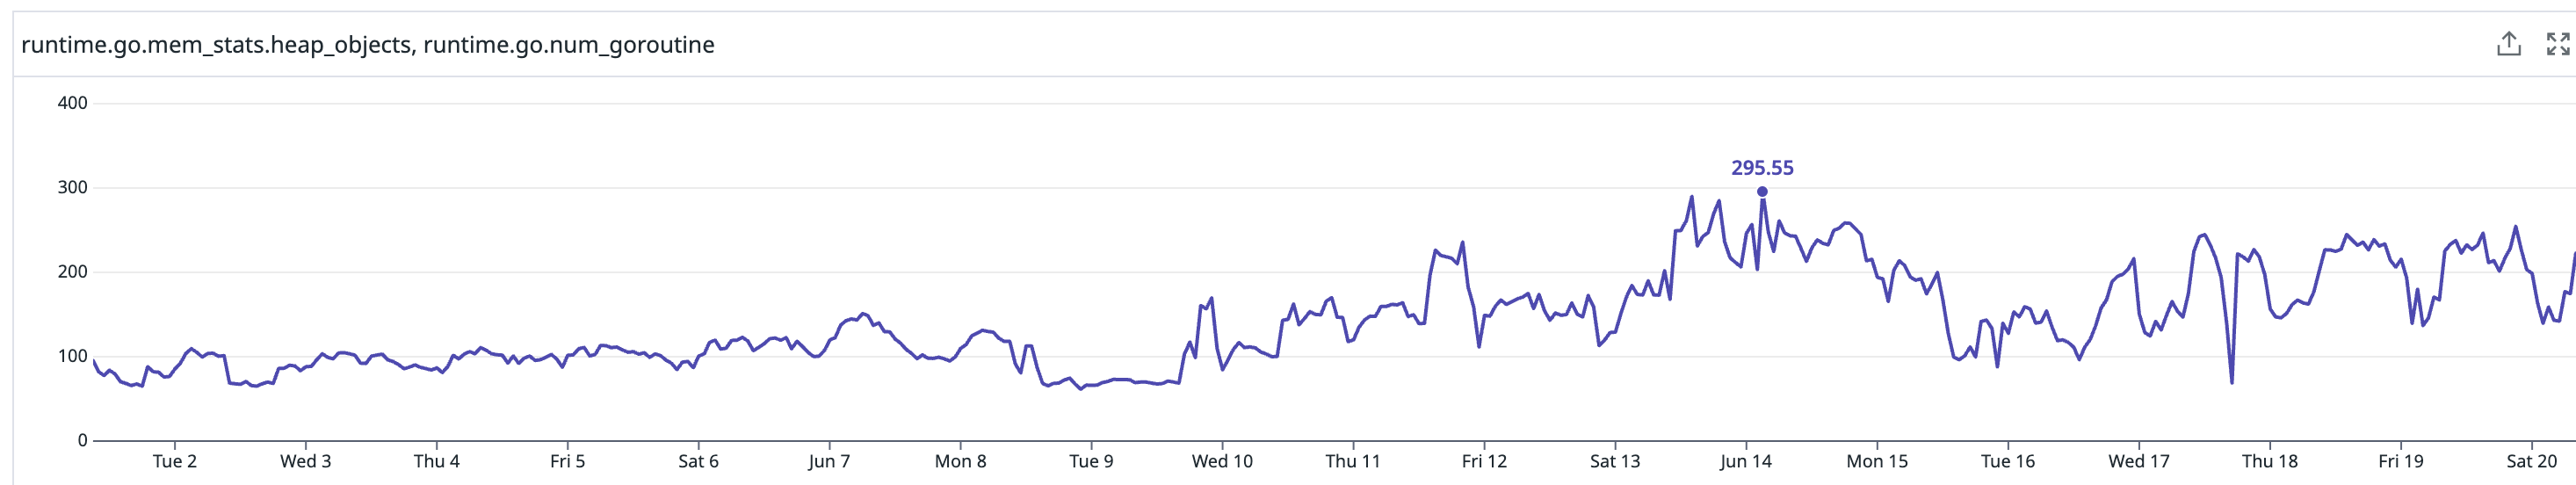
Goのメモリ増加の切り分けにはDatadogを使い、goroutineの数とheap objectsの2つに絞って調査を進めました。goroutineが増え続けていればgoroutineリーク(閉じられていないチャネル待ちなど)、goroutineが横ばいでヒープの生存オブジェクトだけが増えていれば、どこかで参照を持ち続けているヒープリークに絞り込めます。
今回は runtime.go.num_goroutine が横ばいだったため、goroutineリークはまず除外できました。一方で runtime.go.mem_stats.heap_objects は 0.65M個から15.4M個まで直線的に増加していました。1日あたり約130万個のオブジェクトが増え続けている計算です。何かが一定のペースでオブジェクトを生成し、その参照を持ち続けていることになります。
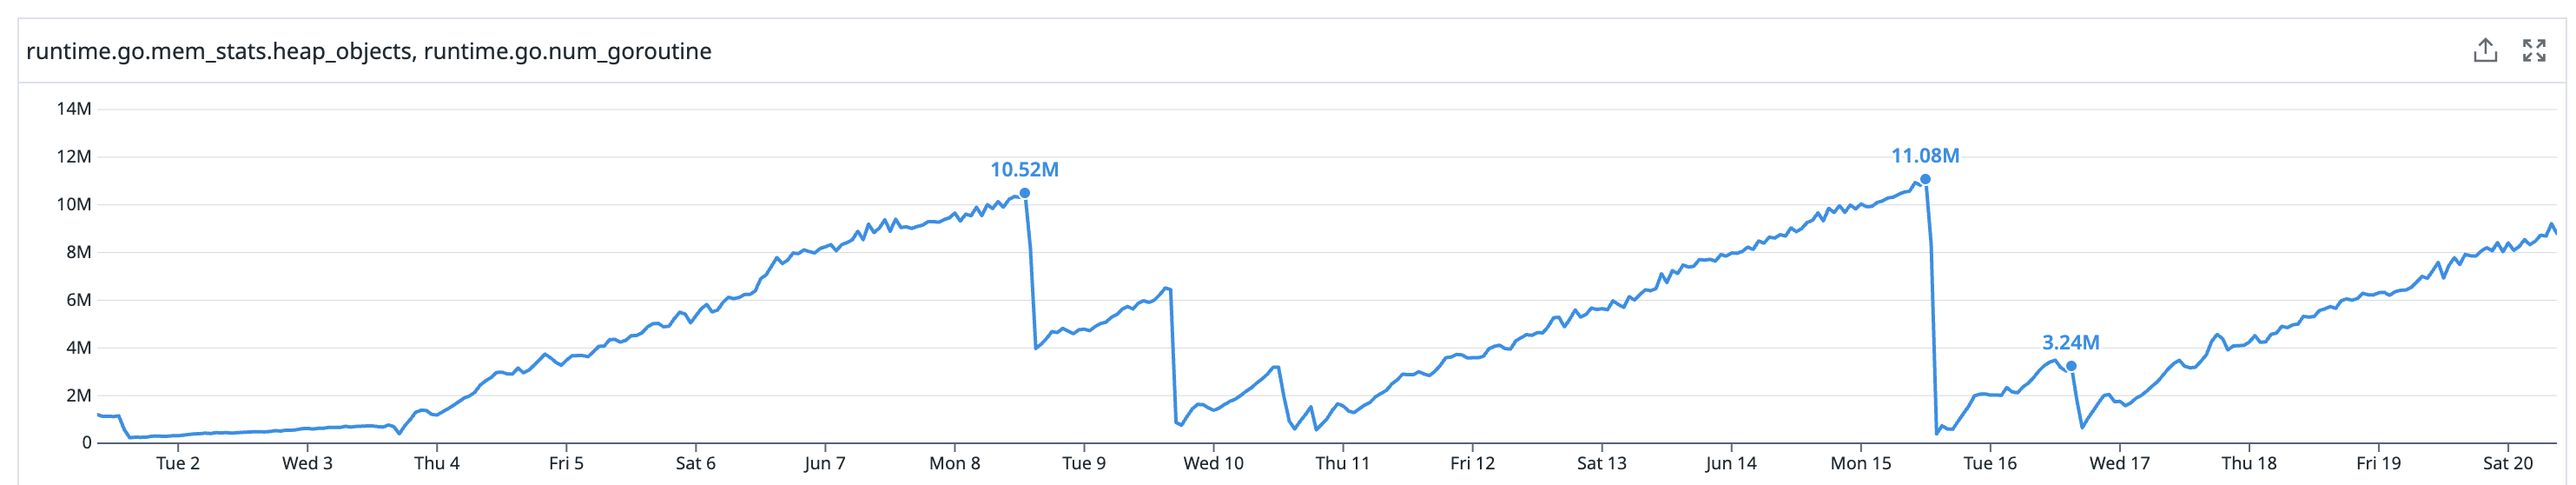
次に「いつから始まったのか」を特定するため、リリースごとのデプロイ時刻とメモリの挙動を突き合わせました。
| バージョン | デプロイ日(UTC) | メモリの挙動 |
|---|---|---|
| v2.1.50 | 05-28 | 6日間、60〜230MBの範囲で安定 |
| v2.1.51 | 06-03 | デプロイ直後から230MBを超えて増加し続ける |
v2.1.50は6日間まったくリークしていないため、原因ではありません。メモリの挙動が変わったタイミングはv2.1.51のデプロイ時刻と一致していました。そしてこのリリースの機能的な差分は、計算結果の管理に2分粒度の集計区間を追加したことだけでした。これがメモリ増加の原因だろうと目星をつけ、あとは「なぜこの変更でメモリが増えるのか」の特定に調査を進めました。
なぜ2分粒度の追加でメモリが増えるのか
このコンポーネントの定期処理は、2分ごとに管理対象ごとの計算結果を 対象ID + 期限時刻 をキーにしてインメモリキャッシュへ書き込みます。期限時刻には「この1時間分」「今日1日分」といった粒度があり、v2.1.51では制御の精度を上げるために「この2分間分」という粒度が追加されました。
ここで、粒度によってキーの振る舞いがまったく変わります。1時間粒度のキーに含まれる期限時刻は1時間に1回しか変わらないため、その間の書き込みはすべて同じキーへの上書きです。キャッシュのエントリ数は増えません。ところが2分粒度のキーは、定期処理の実行間隔と期限の粒度が同じ2分なので、処理が動くたびに新しい期限時刻、つまり新しいキーを生成します。例えば管理対象が100件あるとすると、2分ごとに100個の新しいエントリが積まれ、1時間で3,000個、1日で72,000個になります。
エントリ数が増えること自体は想定外ではありません。キャッシュにはTTLを設定しているので、期限切れのエントリは消え、エントリ数は「TTLの窓に入っている直近の分」で頭打ちになるはずです。ところが、本番のheap_objectsには頭打ちになる気配がなく、直線的に増え続けていました。
そこで、ローカルで同じ状況を再現してみました。TTLを設定したキャッシュに、ユニークなキーを書き込むだけのコードです。結果は本番と同じで、TTLの期限を大幅に過ぎたエントリが削除されず、エントリ数は増え続けました。TTLを付けているのに消えない理由を知るため、go-cacheのライブラリを深掘りし、何がキャッシュを解放しているのかを特定することにしました。
janitorについて
go-cacheの実装でTTLによる削除の仕組みを追っていくと、janitorという存在にたどり着きました。TTLは「このエントリはいつ期限切れになるか」という情報を付けるだけで、付けた瞬間に削除が予約されるわけではありません。期限切れのエントリが扱われるのは、次の2つのタイミングだけです。
Getされたとき: 期限を判定し、切れていれば「存在しない」として返す。ただしこれは論理的な扱いだけで、エントリ自体はメモリに残り続ける- janitorと呼ばれるgoroutineが定期巡回したとき: キャッシュ全体を走査して期限切れを物理削除する(
DeleteExpired)。メモリが解放されるのはこのタイミングだけ
janitorの実装は patrickmn/go-cache v2.1.0 cache.go#L1071-L1100 にあり、巡回間隔は cache.New の第2引数 cleanupInterval で指定します。ドキュメントにも「cleanupIntervalが0以下なら、DeleteExpired() を呼ぶまで期限切れアイテムは削除されない」と明記されています。
ローカルの再現でこれを確かめると、期限切れのキーを Get したときは確かに「存在しない」が返り、TTLの判定自体は正しく動いていました。しかしエントリをメモリから実際に消せるのは、後者のjanitorだけです。janitorが動いていれば、巡回のたびに期限切れのエントリが一掃されるはずです。それなのに、ローカルでも本番でもエントリは積み上がり続けていました。janitorが動いていないのではないか、そう疑って、キャッシュを生成している社内共通ライブラリのラッパーを見ると、原因が見つかりました。
// 社内ライブラリのラッパー(バグあり)
type InMemoryStore struct {
    cache.Cache                                    // 値型で埋め込み
}

func NewInMemoryStore(d time.Duration) *InMemoryStore {
    return &InMemoryStore{*cache.New(d, time.Minute)}  // *Cache をデリファレンスして値コピー
}このコードは何年も前から存在し、多くのコンポーネントで使われてきました。Set も Get も正常に動くため、一見どこにも問題がないように見えます。何が起きているのかを理解するには、go-cache本体の構造を見る必要があります。
go-cacheの2層構造とfinalizer
go-cacheは2017年リリースのv2.1.0が最新で、現在は事実上更新が止まっています。依存がなく小さく安定したライブラリのため、社内でも長く使われてきました。その内部構造は次のようになっています。
// patrickmn/go-cache (抜粋)
type Cache struct { *cache }   // 外側のラッパー: 本体へのポインタを1本持つだけ
type cache struct {            // 本体: items map、mutex、janitor を持つ
    ...
}

func newCacheWithJanitor(de, ci time.Duration, m map[string]Item) *Cache {
    c := newCache(de, m)                     // 本体を確保
    C := &Cache{c}                           // 外側のラッパーを作る
    if ci > 0 {
        runJanitor(c, ci)                    // janitorは「本体c」を参照して動き続ける
        runtime.SetFinalizer(C, stopJanitor) // finalizerは「外側C」に登録される
    }
    return C
}
(抜粋元: patrickmn/go-cache v2.1.0 cache.go#L35-L40、同 #L1113-L1126)
ここで runtime.SetFinalizer について補足します。finalizerは「このオブジェクトがGCで回収されるとき、この関数を実行する」という登録です。go-cacheはこれを使って、キャッシュが使われなくなったときにjanitor goroutineを自動停止させています。janitorはgoroutineなので、誰かが明示的に止めない限り動き続けてしまう(=goroutineリークになる)ためです。
図にすると、go-cacheは2層構造になっていて、finalizerとjanitorが別々の層に紐づいています。
なぜこのような2層になっているのでしょうか。janitorは掃除のために本体 c を参照し続ける必要があります。Goのポインタはすべて強参照なので、janitorが参照している限り c はGCから見て常に到達可能で、利用者がキャッシュを手放しても回収されません。そのため c にfinalizerを付けても発火しません。そこでgo-cacheは、janitorが参照していない外側の C にfinalizerを登録し、利用者が C を手放したタイミングを「キャッシュはもう不要」のシグナルとしてjanitorを止める設計になっています。つまりgo-cacheには、利用者が *Cache を保持している間はjanitorが動き、手放すと止まるという前提があります。
この前提はドキュメントには書かれておらず、ソースコードを読まないと分かりません。
原因の特定
この前提を踏まえて、先ほどのラッパーをもう一度見てみます。*cache.New(...) は、返ってきた *Cache をデリファレンスして中身を値コピーしています。コピーには本体への内側ポインタが含まれるため Set/Get は問題なく動きます。しかし、finalizerが登録された元の C を保持するものがいなくなります。その結果、次のことが起きます。
- 起動直後はjanitorが動いている(このタイミングのテストは通る)
- 以後のいずれかのGCで、どこからも参照されていない元の
Cが回収され、finalizerが発火する - janitorが停止し、以降は期限切れのエントリが削除されなくなる
正常なケースとの違いを図にすると次のようになります。
ポイントは、値コピーで残るのは本体への内側ポインタ(だから Set/Get は動く)で、切れるのはfinalizerが付いた外側 C への参照だということです。本体は生きているのにjanitorだけが停止するため、機能面では何の異常も出ません。
さらに、finalizerが発火するタイミングは保証されていません。対象が到達不能になった後、いずれかのGCサイクルで実行されます。起動直後は正常に動作し、GCが走ったあとに初めて壊れるため、起動してすぐのテストでは検出できません。長時間動き続ける本番プロセスで初めて問題が表面化する、というのが今回のバグの再現しにくさの正体です。
再現テストによる実証
コードを読んだだけで断定せず、「janitorが本当に停止している」ことを再現テストで確認しました。実際の InMemoryStore に対してTTL=2秒でユニークなキーを書き込み続け、janitorの巡回間隔(1分)をまたぐ95秒間の生存オブジェクト数を観察します。
// 再現テストのイメージ
store := NewInMemoryStore(2 * time.Second) // TTL=2秒
for i := 0; ; i++ {
    store.Set(fmt.Sprintf("key-%d", i), value, 2*time.Second) // ユニークキーを書き続ける
    // 定期的に runtime.GC() を実行し、runtime.ReadMemStats で
    // HeapObjects を記録する。janitor(1分間隔)が生きていれば
    // 60秒経過時点で期限切れの大量削除が観測されるはず
}
結果、生存HeapObjectsは47Kから197Kまで増加し続け、一度も減りませんでした。janitorが動いていれば60秒の時点で大きく減るはずなので、janitorが停止していることを実際の挙動として確認できました。本番で起きていること(直線的な増加、頭打ちなし)とも一致します。
修正
根本原因は、ラッパーがgo-cacheの寿命管理の前提を破っていたことにあります。そのためライブラリ側のラッパーを修正します。アプリケーション側で2分粒度のキーの扱いを見直しても今回の症状を止める対症療法にしかならず、janitorが停止している事実は他の全利用箇所に残り続けるためです。
修正は値埋め込みをポインタ埋め込みに変えるだけです。
// 修正後
type InMemoryStore struct {
    *cache.Cache                                   // 値埋め込み → ポインタ埋め込み
}

func NewInMemoryStore(d time.Duration) *InMemoryStore {
    return &InMemoryStore{cache.New(d, time.Minute)}  // C をそのまま保持する
}
InMemoryStore が生きている間はfinalizer付きの C も到達可能なままになるため、janitorは停止しません。Goの埋め込みフィールドはポインタでもメソッドが昇格される(promoted methods)ので、Set/Get を呼んでいる利用側のコードは一切変更不要でした。diffの本質は * の位置を1文字分ずらすことだけです。
影響範囲の調査
共通ライブラリの修正なので、修正を入れる前に NewInMemoryStore を使っている全コンポーネント(13箇所)を調査しました。janitorはどの利用箇所でも同じように停止していますが、実害が出るかどうかはキャッシュキーの性質次第です。Get されても物理削除はされないため、リークが成立するかどうかはキーが際限なく増えるかどうかで決まります。固定キーや安定IDのキーであれば書き込みは同じキーへの上書きになるので、janitorが停止していてもメモリは一定の範囲に収まります。
| 判定 | 件数 | 理由 |
|---|---|---|
| 深刻(OOMに至る) | 1(今回のコンポーネント) | 時刻入りのキーを2分ごとに際限なく生成する |
| 少しずつリーク | 1 | 期間入りのキーで1日あたり約20MB増。OOMには未到達 |
| 実害なし | 11 | キーが固定・安定IDのため、上書きが支配的 |
結果
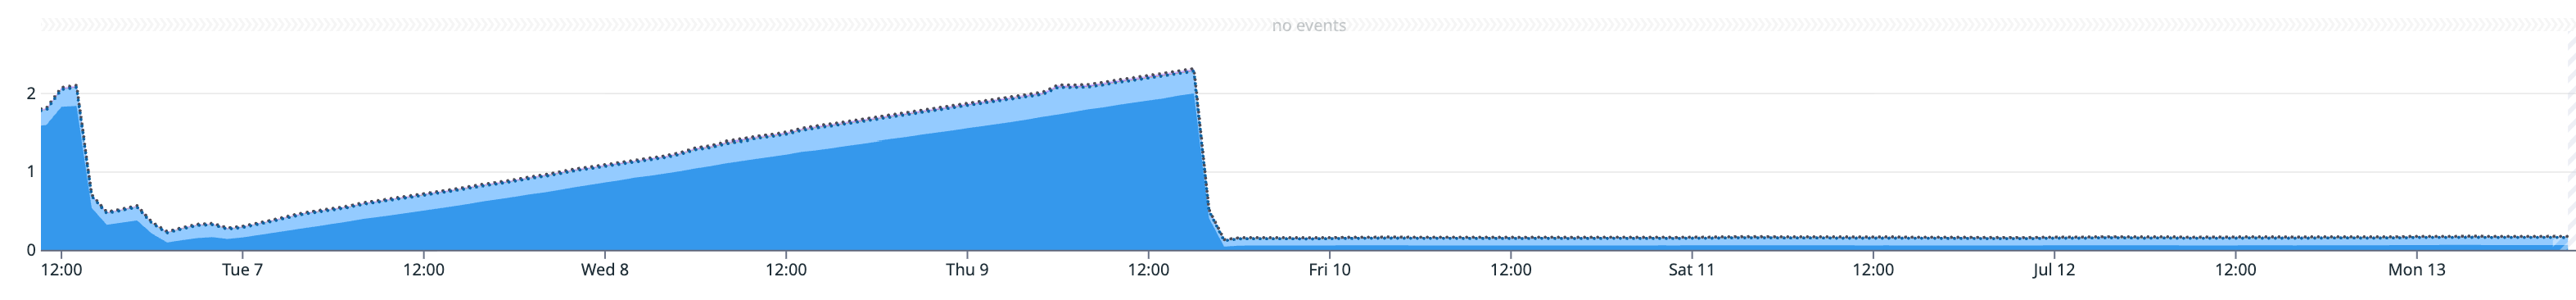
ライブラリの修正とバージョン更新で、今回のコンポーネントのOOMKillは解消しました。少しずつリークしていたもう1つのコンポーネントも同時に解消しています。ライブラリ側での修正のため、全13箇所の利用側に恒久的に効き、今後 NewInMemoryStore を使う新しいコードも自動的に正しい挙動になります。
go-cacheの設計を今の視点で振り返る
修正は1文字で済みましたが、そもそもなぜこのような壊れ方をする構造になっていたのかを考えてみます。
go-cacheが解きたかった問題は「利用者がキャッシュを手放したら、janitor goroutineを止めたい」というものです。しかしjanitorは掃除のために本体を参照し続ける必要があり、Goのポインタはすべて強参照なので、janitorが参照している限り本体は回収されません。利用者が手放したという出来事をGCから観測できないのです。そこで本体とは別に外側のラッパーを用意し、ラッパーの回収をfinalizerで検知して合図に使う、という迂回路が取られました。
これは2017年当時のGoでは合理的な工夫だったと思います。ただ、この方式は本来知りたい本体の寿命ではなく、代理オブジェクトの寿命を観測しているため、「ラッパーを値コピーすると壊れる」という利用者に見えないバグが生まれました。今回のバグはそれを踏んだものです。
今のGoなら、この問題はより素直に解けます。Go 1.24で標準ライブラリに weak パッケージが入り、弱参照が使えるようになりました。弱参照は対象を指しつつも、GCが生存判定をするときには参照として扱われません。janitorが本体を弱参照で持てば、利用者が手放した本体は次のGCで回収され、janitorは次以降の巡回で弱参照がnilになっていることを見て自分で終了できます。外側のラッパーもfinalizerも不要になり、本体そのものの寿命が利用者の参照だけで決まります。
また、go-cache自体は前述のとおり更新が止まっているため、他のライブラリへの移行も検討していきたいと思います。
終わりに
今回の調査は、メトリクスの形(goroutine数は横ばい、heap_objectsは直線増加)からリークの種類を絞り込み、デプロイ時刻との突き合わせで原因リリースを特定し、コードを読んで仮説を立て、再現テストで裏を取る、という流れで進めました。普段から取れているメトリクスとコードリーディングの組み合わせで根本原因までたどり着けました。
技術的な学びとしては、次の3点が大きかったです。
- TTLは期限の情報を付けるだけで、削除する仕組みが別に動いていなければエントリは消えない
- ライブラリが返すポインタには、参照以上の意味(所有権やライフサイクル)が乗っていることがある。
runtime.SetFinalizerが登録されたオブジェクトを値コピーすると、finalizerはコピーに引き継がれない - 言語機能が進化すると、かつての回避策は不要になる。長く使っているライブラリの前提を、今の言語の視点で見直す価値がある
また、本番で長時間動かして初めて現れる挙動を捕まえられるかどうかは、日頃のメトリクス整備にかかっているのだと改めて感じました。
今回の経験を、今後のライブラリ設計やコードレビューにも活かしていきたいと思います。最後まで読んでいただきありがとうございました。
サイバーエージェントでは、社会人経験のある方を新卒として迎える「Re:Career採用」を積極的に行っています。ご興味のある方は、ぜひご応募ください。
https://www.cyberagent.co.jp/careers/special/students/tech_potential/