

はじめに
ピグ事業部で SRE を担当している松岡 (@htk1008)です。
昨今の AI の進化を受けて、開発だけでなく運用面でも AI 活用事例が増えてきたと感じています。監視やアラート対応もそのひとつで、AIエージェントに調査を任せる動きは、今後さらに主流になっていくと思います。
私たちのチームでは、Datadog のアラートが Slack に届いた際の調査を Devin Automations に任せる運用を続けてきました。本稿では、そのなかで特に精度向上に繋がったポイントを 4 つご紹介します。Devin の機能を前提にした話ではありますが、他の AIエージェントや自前の仕組みで運用を検討している方にとっても参考になれば幸いです。
Devin Automations とは
Devin は、コードの作成から実行・テストまでを一通り担える AI ソフトウェアエンジニアです。この Devin を、Slack や GitHub のイベントを起点に自動で起動できる仕組みが Devin Automations になります。
アラート調査で便利だったのは、最初から一連の流れの骨組みが用意されている点です。Slack 投稿を受けてセッションが開始し、シェルや CLI、MCP 経由でログやクラウドを確認し、スレッドに報告する。セッション内容をスクラッチパッドに保存して、セッション自体の分析もできる。こうした一連の作業を、自前のオーケストレーションを構築する必要がなく始められます。
こちらを採用した理由は大きく 2 つあります。ひとつは、開発や定常業務ですでに Devin を使っていたため、普段使いの延長で運用に載せられる点を重視したことです。もうひとつは、調査を特定プロダクトに閉じたくなかったことです。システム障害だけでなく運用起因の障害も少なくありません。AWS DevOps Agent や Datadog Bits AI のような選択肢もありますが、特定ツール上の調査だけで完結させず、GitHub・クラウド・Slack などを横断して切り分けられる汎用的な AI エージェントのほうが合いました。
課題
ピグ事業部では複数のサービスを運用しており、各プロダクトを Datadog で監視して、アラートを Slack に流しています。Datadog モニターに加えて、クラウド側のエラー通知や DB のマネージドサービスの通知も、同じチャンネルに集約されます。
監視・アラート対応では、主に 3 つの課題がありました。
- 初動が人に依存する
- 通知を見て「既知問題か新規問題か」「影響範囲はどの程度か」「優先度はどれくらいか」を判断する作業が人頼みになり、見落としや判断の遅れが起きていました。日中は本業の合間に差し込まれるため、優先度が下がることもありました。
- 監視範囲が広く、調査の難度が高い
- アプリエラー、SLO 低下、レイテンシー悪化、デッドレター滞留、DB の CPU 使用率上昇、Pod のクラッシュや OOM など、アラートの種類が多く、切り分け方法もさまざまで調査に時間がかかります。
- 休日・深夜も対応が必要になり得る
- 出先では PC がなく対応できない、ローカル環境でないと調査や暫定対応が難しい、経験のあるメンバーでないと対応しづらいなど、人や環境への依存がありました。
そこで、アラートの調査は AI に任せ、必要に応じて暫定対応・修正 PR まで作ってもらえる体制を整え、誰もが対応から解決まで自走できる環境を目指しました。
構成
インフラは Google Cloud / AWS / Azure に加え、オンプレミスも混在しています。横断的な監視は Datadog、メインのアプリログは Cloud Logging、エラー管理は Error Reporting を使用しています。
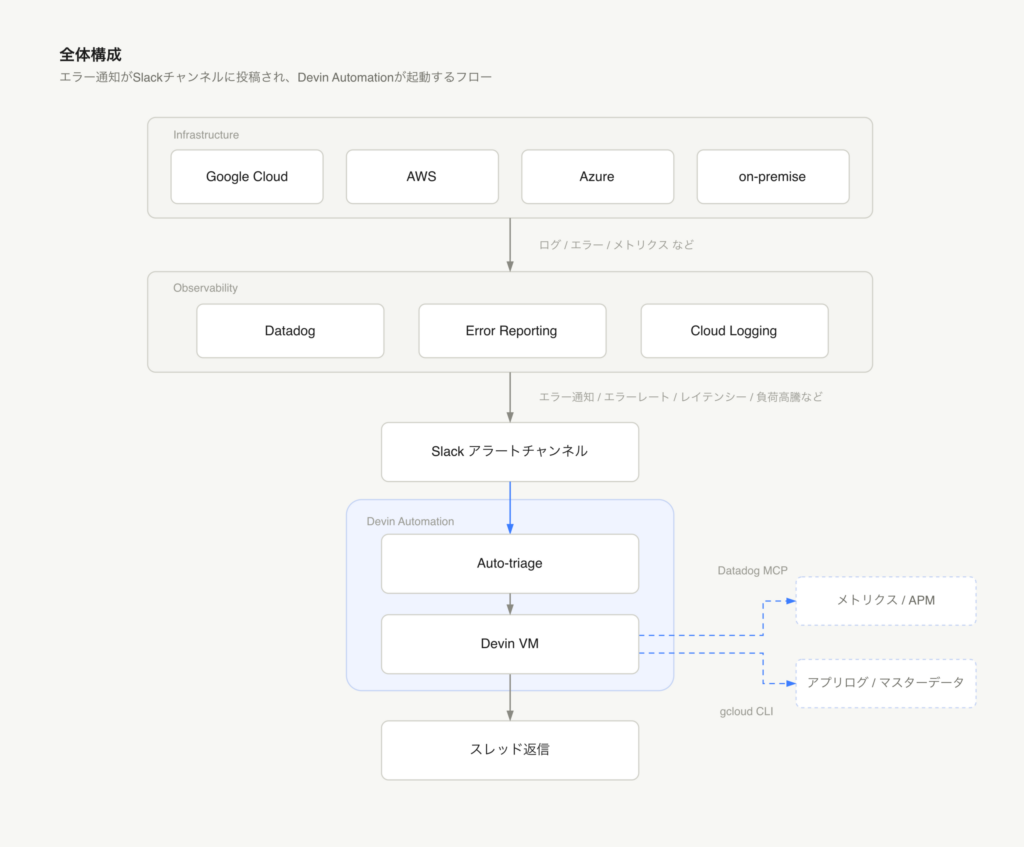
Datadog モニターや Error Reporting の通知で Devin が起動し、Datadog や Cloud Logging などを見た結果、元メッセージへのリアクションとスレッドで返します。やらせているのは調査までで、復旧操作や監視設定の変更はさせていません。Devin は OIDC 認証 に対応しているので、サービスアカウントキーを VM に置かずに済みます。
実際のスレッドは、次のような形です。
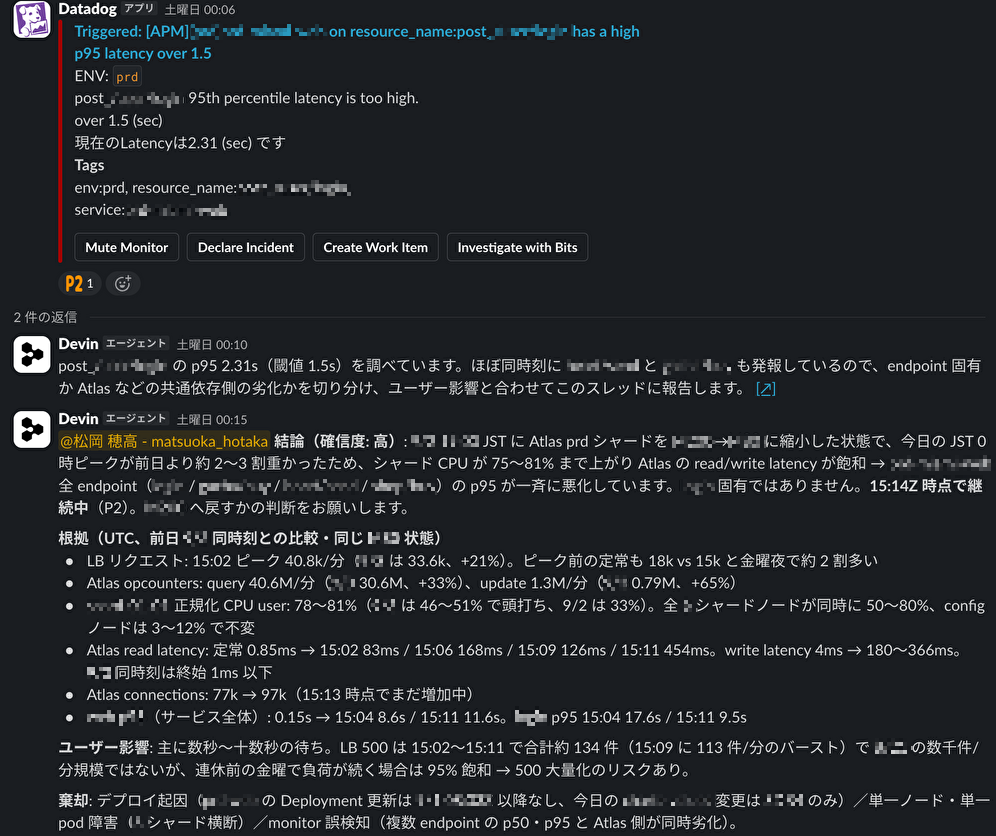
この例では、特定 API のレイテンシーアラートを受けて、影響範囲・根拠・棄却した仮説・判断依頼まで揃った報告が返ってきています。緊急度は Slack スタンプで表現するようにしています。
こうした調査を安定させるうえで、特に精度向上につながったポイントは次の 4 つです。
- オブザーバビリティを高める
- クラウド環境を整える
- 仮説検証を直列ループで回す
- 調査プロセスを評価する
ポイント① オブザーバビリティを高める
運用を始めて最初に気づいたのは、AI が判断を誤るケースの多くは、人間が同じ情報を見ても判断が難しいものだった、ということです。当たり前と言えば当たり前ですが、意外と見落としがちな点でした。プロンプトに「慎重に判断せよ」と付け足しても、ログが欠けている、メトリクスが取れていないなど判断材料がなければ、推測するしかありません。
そのため重要なのは、AIが調査に必要な情報へ適切にアクセスできる環境を整えることでした。人が調査していた頃は経験や暗黙知で補えていた情報不足も、AI に任せると調査の行き詰まりとして表れます。そこで、実際に調査で詰まった問いを起点に、必要な観測を追加していきました。例えば、ログのリクエスト情報を使ってロードバランサの 500 エラーとアプリ例外を追跡できるようにする、APM で API ごとのレイテンシーや DB のスロークエリを確認できるようにする、といった改善を重ねています。
監視データの定義を整理
観測が増えると、次に効くのは「どの情報源で何を語るか」を整理することです。よくある失敗は、監視データの性質を無視して判断してしまうことでした。例えば、次のようなケースは AI に前提情報を伝えておく必要があります。
- APM のトレースはサンプリングされているため、「成功しているリクエストが見える=影響なし」とは言えない。影響範囲を判断するときは、エラーレートやログの実数も確認する。
- 平常時の水準と比較せずに、「急増」と判断しない。前日同時刻や前週同曜日など、同じ長さの時間窓と比較する。
調査の情報源
| 見たいもの | 使うもの | 定義 |
|---|---|---|
| 成功 / 失敗の実数 | Cloud Logging | ログの件数を確認し、影響が全体か一部かを判断する |
| リクエスト単位の追跡 | Cloud Logging | 1 リクエストや 1 ユーザーの流れを、ログをつないで追う |
| マスターデータ | Cloud Storage | 設定中のマスタデータからIDや公開期間を見る |
| 時系列の形・ベースライン・閾値 | Datadog | 平常時との差や急変を、メトリクスの形と閾値で見る |
| 例外の中身・スタック | Error Reporting / GitHub | 例外メッセージとスタックトレースから、ソースコード上の原因候補を特定する |
| デプロイ履歴 | GitHub | 直近の変更やリリース有無を確認し、変化点と突き合わせる |
システム全体の正本を 1 つ用意する
「どのサービスがどこで何をしているか」は、Terraform や Kubernetes マニフェストから都度組み立てることもできます。ただ、それを毎回 AI に読ませると、本来の調査に入る前にトークンと時間を消費してしまいます。
そこで、サーバーの役割や環境の見分け方、各クラウドサービスの役割などをまとめた「システム全体マップ」を 1 つのファイルに整理しました。詳細な構成の正本は IaC に残したまま、調査の入口となる情報だけを簡潔にまとめています。
アラートが発生したサーバーの役割や関連サービスを、最初から AI に前提知識として渡しておくことで、調査をスムーズに開始できるようになりました。
ポイント② クラウド環境を整える
Devin は VM 上で動作します。人がローカル環境を使って作業するのと同じように、AI エージェントにも調査を行うための環境が必要です。
毎回 VM の初期セットアップから始めると、通知を受けてから最初の報告までに数分から十数分かかることがあり、初動が遅れてしまいます。そこで、セッション開始直後から調査に入れる状態を、あらかじめ用意しておく必要がありました。
Environment と blueprint で環境を焼き込む
Environment は、Devin セッションが起動する VM 環境の設定単位です。ツール・依存関係・リポジトリ・認証を blueprint で定義し、ビルドで Snapshot(起動用イメージ)に焼き込み、セッションは毎回そのコピーから VM を起動します。各リポジトリは .devin/blueprint.yaml で個別のセットアップを持ち、それらは1つの Snapshot にまとめて反映されます。
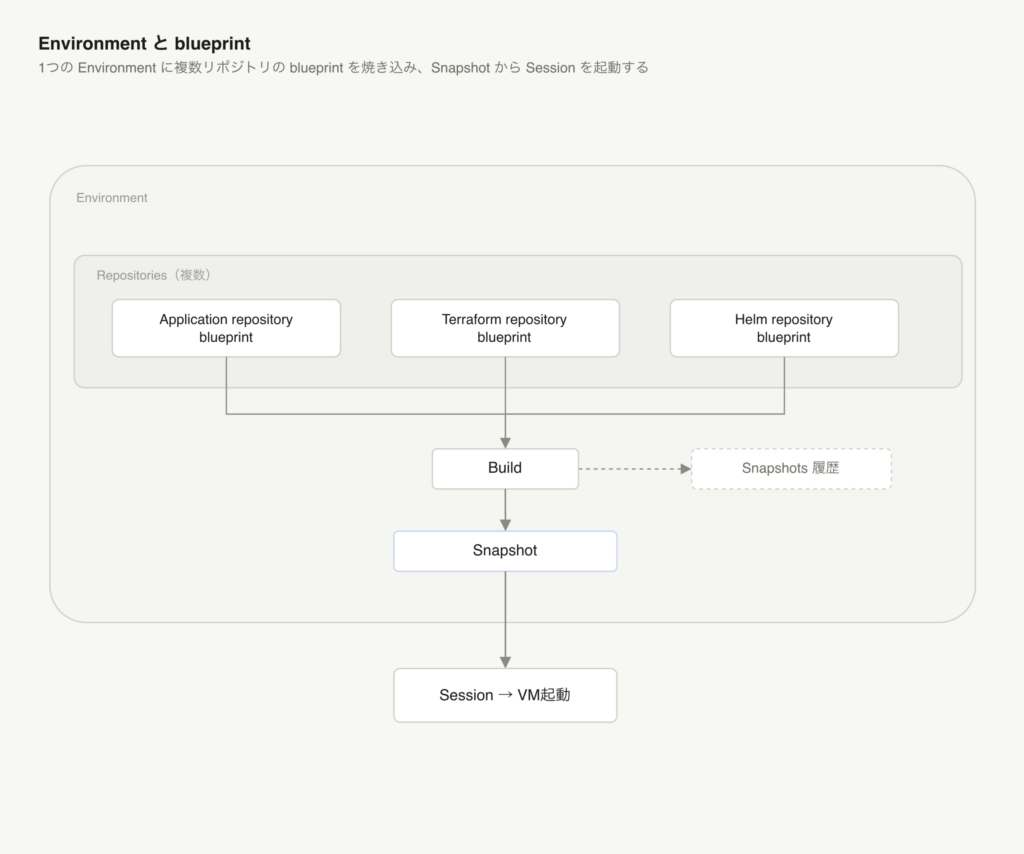
ピグ事業部では、複数のプロダクトと各チームのリポジトリを 1 つの Organization で管理しています。調査に関係するリポジトリはすべて Environment に含め、セッション開始時点でクローン済みの状態にしています。これにより、リポジトリを探すことなく、すぐに調査へ移れます。
当初は、CLI に PATH が通っていなかったり、シェル初期化の読み込み順によって PATH が上書きされたりするなど、環境まわりでつまずくことも多くありました。そこで、gcloud や kubectl などの CLI、認証プラグイン、パッケージマネージャをあらかじめ環境に組み込み、Workload Identity によるクラウド認証も設定しました。
必要な環境を事前に用意しておくことで、毎回のセットアップが不要になり、セッション開始後の調査をスムーズに進められます。
調査手順は Skills に置く
調査手順は当初 Devin の Playbook に書いていましたが、現在はリポジトリ内の Skills に置いています。移行理由は以下の通りです。
- Devin 以外からも使える
- ローカルの Claude Code や Cursor からも、同じ手順・同じスクリプトを呼べます。Devin が調べた手順を人が再現するのも、人が試した手順を Devin に渡すのも、同じ Skills で回せます。
- GitHub でバージョン管理できる
- Playbook は Devin の UI 上にあるため、変更に気づきにくいです。Skills を GitHub 管理にすることで、調査プロセスを明文化しやすくなります。
ポイント③ 仮説検証を直列ループで回す
アラート調査は、情報収集して仮説を立て、外れたら次を試す——この繰り返しになります。最初はスピードを上げようと並列化も試しましたが、結果としてあまりうまくいきませんでした。現在は 1 エージェントで直列にループさせるフローに落ち着きました。
失敗パターン
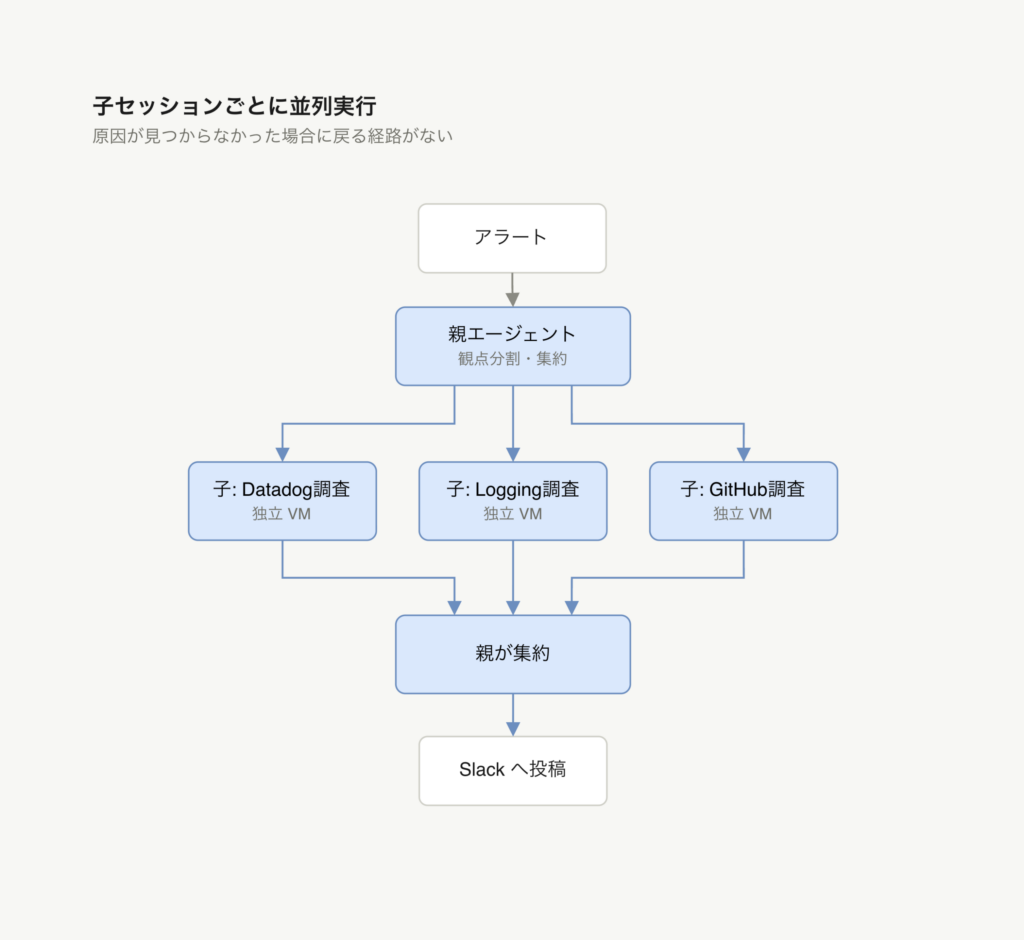
初めは、子セッションという独立した VM に Datadog・Cloud Logging・GitHub それぞれの専用調査を委任し、親エージェントが結果を集約する構成にしていました。並列実行すれば、調査を速く終えられると考えたためです。
しかし実際には、子セッションは割り当てられた情報源を 1 回確認して返すだけでした。調査が空振りに終わると、「該当なし」と報告するか、推測で補って終了します。親エージェントも結果を集約するだけになり、追加の調査につなげられませんでした。
また、子セッションはそれぞれ別の VM で動作するため、何を確認し、どの仮説を棄却したのかという過程が共有されにくく、子セッションから親エージェントへの伝達時に情報が欠落することもありました。
並列化が悪かったというより、仮説検証としてつながっている調査を、情報源ごとの別作業に分断してしまったことが問題だったと考えています。
安定パターン
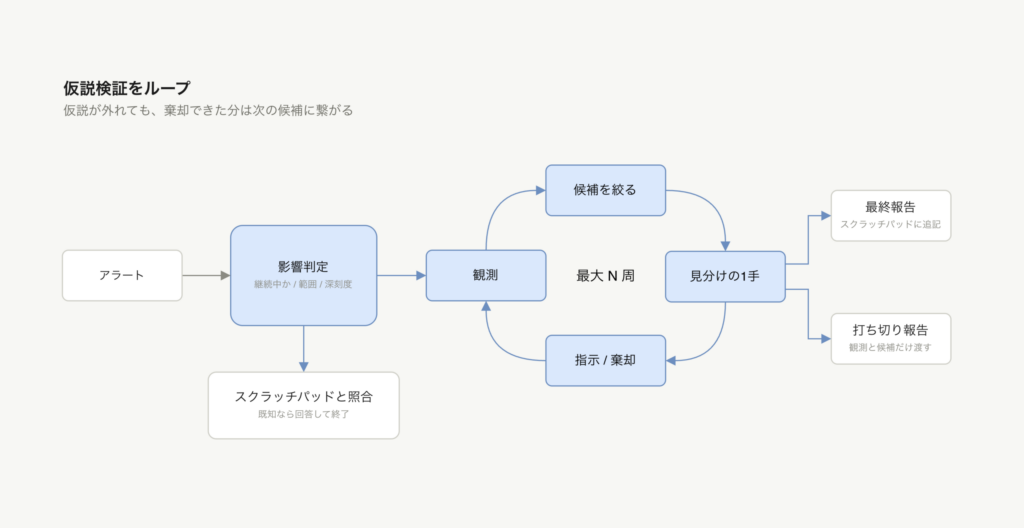
そこで、調査は 1 エージェントに集約し、仮説の棄却と追加確認を同じセッション内で繰り返す形にしました。工程数自体は大きく変わりませんが、調査が空振りしたあとにすぐ別の確認へ移れること、原因の絞り込みや予算上限をもとに調査を止められることが大きな違いです。
この形は Google SRE — Effective Troubleshooting の考え方を参考にしています。現在は、最大 3 周まで調査を繰り返すよう指示し、1 セッションあたりの ACU 上限も設定することで、無限ループを防いでいます。
調査には、次の 3 つの制約を設けました。
- 型
- 影響判定 → 既知問題との照合 → 仮説検証。既知問題であれば、仮説検証には進まない
- 予算
- 周回数とクエリ数に上限を設ける。上限に達した場合は、「分かったこと」「棄却した仮説」「未確認事項」を整理して終了する。Devin Automations 側でも、1 セッションあたりのコスト上限を設定している
- 証拠の基準
- 仮説を区別できる観測があり、対立仮説を棄却でき、因果関係を説明できるまでは断定しない
どの情報源をどの順番で確認するかは、あえて固定していません。アラート調査では、最初から確認すべき情報や正解が決まっているとは限らないためです。Step 1、2、3… と手順を細かく定めるよりも、調査の型・予算・証拠の基準という制約だけを渡すほうが、さまざまなアラートに対応しやすいと分かりました。
既知問題の扱いは、Devin の Auto-triage で判断しています。似たアラートをまとめたうえで、スクラッチパッドに記録された過去調査を参照し、同じ事象なら本調査のループに入らずに打ち切れます。
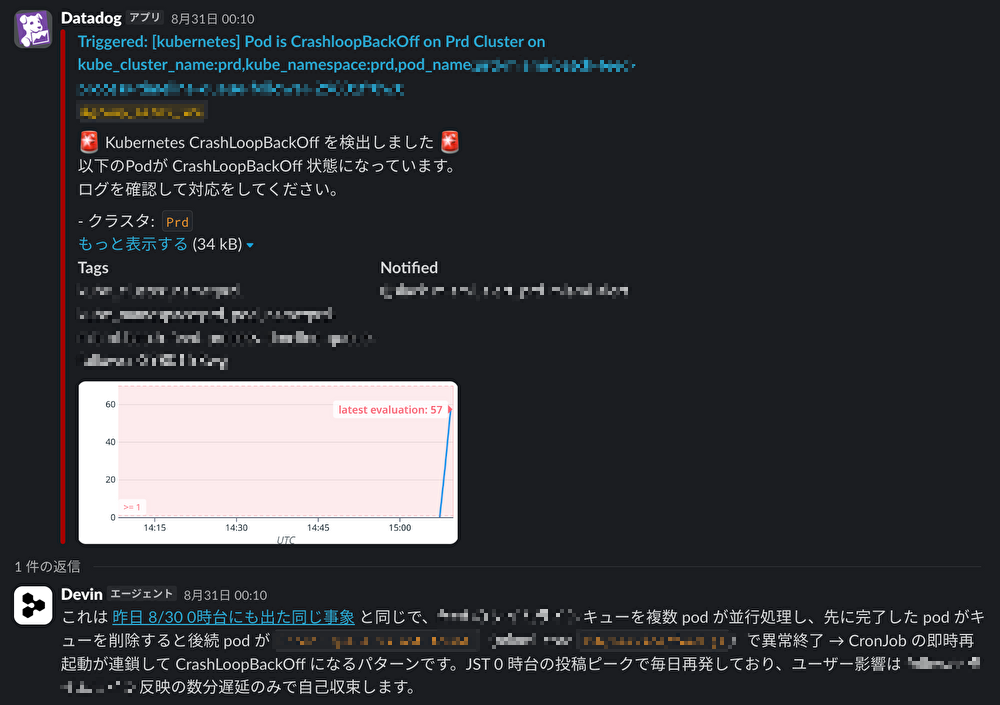
この例では、CronJob の CrashLoopBackOff 通知を進行中のバッチ再起動と同一事象と判断し、調査結果を元のスレッドに集約しています。重複するアラートの調査を省略できるほか、元のスレッドへの Slack リンクから、初回アラートや調査内容もすぐに確認できます。
ポイント④ 調査プロセスを評価する
Devin には、セッションの内容を分析する「Session Insights」という機能があります。別の Devin がセッションの内容を分析し、問題点や改善点を特定してくれるものです。
調査がうまくいかなかったときは、Session Insights を使ってセッションを振り返るようにしました。これまでの分析では、失敗の原因は概ね「環境」「知識」「権限」「計測」の 4 つに分類できました。
| 分類 | 典型例 | 反映先 |
|---|---|---|
| 環境 | CLI がない・PATH が通っていない | blueprint |
| 知識 | 監視データの読み方が曖昧・サービス構成の情報不足・コマンドの使い方が非効率 | Knowledge / Skills / Script |
| 権限 | 権限不足・ネットワークアクセス許可がない | IAM(Terraform)/ Devin Secrets / MCP |
| 計測 | ログ・メトリクスが計測できてない・アラート設定がない | Datadog / アプリケーション |
たとえば、APM 上で成功リクエストが見えるだけで「影響なし」と判断してしまったセッションは、監視データの特性に関する知識不足が原因でした。そこで、APM のサンプリング結果だけで判断せず、エラーレートやログなど、より網羅的な情報と突き合わせる方針を Skills に明文化しました。一方、PATH が通っていない問題は環境不備として、blueprint に必要な設定を組み込みました。
ポイントは、何でもプロンプトのせいにしないことです。CLI がない問題を指示文で回避したり、ログがない状態を推測で補わせたりすると、例外ルールだけが増え、根本原因が解消されません。
まとめ
アラート調査を AI に任せて実感したのは、「うまく答えさせる」こと以上に、「正しく調べられる環境を構築する」ことが重要だということでした。初動の切り分けを AI に任せることで、24時間常にアラート調査は任せられるようになりましたし、私たちはその後の意思決定に集中できるようになりました。また、冒頭で挙げた「初動の属人化」「調査コストの高さ」「対応に必要な時間や環境への依存」といった課題の解消にもつながったと思います。
今後も AI を積極的に活用し、DevOps や SRE の領域における運用改善を推進していければと思います。
最後までご覧いただきありがとうございました。