

はじめに
はじめまして。2026年9月に CA Tech JOB 生として1ヶ月間インターンシップに参加しました、近畿大学 情報学部 情報学科の南 健斗です。配属先は AI 事業本部 アドテクカンパニー内の ProFit-X でした。
今回話すこと
今回のインターンでは、広告配信タグの CI フロー改善に取り組みました。結果として、CI 全体の実行時間を 51.3%、実行コストを 63.2% 削減しています。
この記事では、次の3点についてお話しします。
- E2E テストだけを CodeBuild-hosted GitHub Actions runner(以降 CodeBuild-hosted runner)で動かすハイブリッド構成にした話
- runner 用の AWS リソースを Terraform で定義し、apply を GitHub Actions 経由に限定した話
- E2E テストを4並列にし、約18分を6分20秒にした話
なお、初週に「設計や実装の場面で自分の判断の根拠を持ち、自信を持って提案できるようになる」という目標を立てました。これから書く内容は、ほとんどがその目標に向けた試行錯誤の記録です。
改善前の CI と、依頼されたタスク
対象プロダクトと CI の前提
今回改善を行ったのは、ProFit-X が配信している広告配信タグの CI です。広告配信タグは JavaScript で書かれており、Web ページへ組み込まれ、広告の呼び出し、表示、計測を制御します。2026年で11年目を迎えるプロダクトで、月間1億インプレッション以上を扱っています。
多数のメディアへ配信されるプロダクトであり、不具合が出たときの影響範囲は広くなります。そのため Pull Request のたびに、Lint からユニットテスト、E2E テストまでを自動で実行しています。
ここで押さえておきたいのは、E2E テストの性質です。このテストはブラウザを起動し、実際の配信サーバーへ接続して、広告が正しく表示されるかを確認します。この外部通信が、のちに GitHub Actions への移行でつまずく原因になります。
改善前の CI 構成
移行前の CI は、すべて AWS CodeBuild(以降 CodeBuild)の上で動いていました。
Pull Request が作られると CodeBuild のビルドがひとつ起動し、その中でシェルスクリプトが各処理を順番に実行します。依存関係の解決、ESLint、コードフォーマットの確認、開発用ビルドとユニットテスト、そして本番用ビルドと E2E テスト。これらが1本の流れとして直列に走る構成です。
所要時間は1回あたり1,132秒、19分弱でした。そのうち E2E テストが約18分を占めます。
この構成で困っていたのは、結果の見え方です。
CodeBuild のビルドはひとつなので、GitHub の Pull Request 画面に並ぶのも1項目だけです。成功か失敗かは分かりますが、どの段階で落ちたのかはそこからは読み取れません。ログも一括でしか参照できないため、原因にたどり着くには CodeBuild のコンソールを開き、長いログを遡る必要がありました。
依頼されたこと
チームから依頼されたのは、Pull Request 時の CI を GitHub Actions へ移行することでした。
背景にあったのは、先ほどの「結果の見え方」です。GitHub Actions であれば各処理を Job 単位で分割でき、それぞれの結果とログを Pull Request の画面から直接たどれます。どこで失敗したのかが一目で分かる状態にしたい。これが移行に踏み切った理由のひとつでした。
GitHub Actions への移行:E2E テストだけが動かない
まず素直な構成で組んでみる
GitHub Actions は以前から好んで使っていたため、どう組めばよいかの見当はついていました。移行の方針も単純です。既存の CI が一連のフローとして実行していた処理を GitHub Actions の Job へ分割し、すべて GitHub-hosted runner の上で動かす。ただ、それだけです。
Job は4つに分けました。
- lint : ESLint とコードフォーマットの確認。あわせて describe.only などの混入も検出する
- build : 開発用ビルド、ユニットテスト、本番用ビルドを順に実行し、成果物を artifact として保存する
- e2e-test : build の成果物を受け取り、E2E テストを実行する
- comment-e2e-result : 結果を Pull Request のコメントへ書き出す
区切り方は、改善前のシェルスクリプトが実行していた流れをほぼそのまま踏襲しています。
lint と build は想定どおりに移行できました。問題は e2e-test でした。
E2E テストだけが通らない
E2E テストの結果は、予想と逆でした。
| 環境 | 所要時間 | 結果 |
| CodeBuild(既存 CI) | 約18分 | 成功 |
| GitHub-hosted runner(初期試行) | 約32分 | 17ケース失敗 |
速くなることを期待して移行したにもかかわらず、14分ほど遅くなり、しかも17ケースが落ちています。
失敗の中身は、期待した計測リクエストが1件も観測できていない、というアサーションエラーでした。
同じテストは、ローカルでも既存の CI でも成功します。GitHub-hosted runner の上でだけ落ちる。この時点で、原因の見当はついていませんでした。
原因の切り分け
実際に辿った順序で書きます。
- ワークフロー定義に問題はなかった
移行作業の直後だったため、まず自分の記述ミスを探しました。Job の走らせ方や、ワークフロー全体の書き方を見直しましたが、原因は見つかりませんでした。
- 時間を使っていたのは、失敗した17ケースのほうだった
次に実行ログを読もうとしました。ところが E2E テストのログは7万行を超えており、順番に読んでいては終わりません。約14分の差は処理性能だけでは説明がつかないと考え、個々のエラー行ではなく、どこで何秒使っているかを見ることにしました。
そこで生成 AI へログを渡し、整理を任せました。仮説を立てるのは自分、膨大なログから裏付けを探すのは AI、という分担です。
分かったのは、時間の偏りでした。成功した79ケースは、合計しても11分ほどにしかなりません。残りのおよそ20分を、失敗した17ケースが使っています。
失敗するまでに時間がかかる。ここでテストコードを読みに行きました。
- 固定秒待機が43箇所、リトライは最大6回
テストコードを読むと、2つの構造が見つかりました。
ひとつは固定秒待機です。page.waitForTimeout が34ファイルに43箇所あり、内訳は3秒が21箇所、5秒が15箇所、15秒が3箇所、2秒が2箇所、10秒と1秒が各1箇所でした。最も長い15秒の3箇所は、いずれもネイティブ動画広告のテストです。描画に時間のかかる広告の表示を確実に待つために入れられたものと考えられます。
もうひとつはリトライです。this.retries(5) が29箇所にあり、失敗したテストは初回と再試行を合わせて最大6回実行されます。
この2つが組み合わさると、接続の失敗がエラーとしてすぐには現れません。失敗するたびに固定の待機を挟みながら6回まで試行するため、症状はエラーではなく遅延として観測されます。
- 14分の差は、待機とリトライで説明できた
待機時間の長いテストから順に、失敗したときの所要時間を見積もってみました。
とくに重いのは、ブラウザ統合バナーのテスト(1ケースあたり10秒が9ケース)と、ネイティブ動画広告のテスト(1ケースあたり30秒が3ケース、15秒が2ケース)です。ネイティブ動画広告は1ケースの中で複数の待機が積み上がるため、1ケースあたりの待機が長くなります。
合わせて14ケース。これらが毎回失敗して6回まで再試行されると、待機だけで1,260秒、21分に達します。落ちていたのは17ケースなので、その大半が待機の長いテストだったと考えれば、成功した79ケースの11分と合わせて、観測された約32分にちょうど届きます。
ここで理解が変わりました。GitHub-hosted runner が遅いのではなく、特定の条件が満たせずにテストが失敗し、リトライが最大回数まで走った結果、固定待機の分だけ所要時間が膨らんでいたのです。
- 送信元 IP は国外からだった
では、なぜ GitHub-hosted runner の上でだけ条件が満たせないのか。そう考えたときに、実行環境の所在地に思い至りました。
GitHub-hosted runner のうち Windows と Ubuntu は Azure 上で動いており、送信元 IP も Azure のデータセンターと同じレンジから割り当てられます。
GitHub の API から実際のレンジを取得し、Azure が公開しているリージョン別の IP レンジと突き合わせてみました。該当したのは北米・中米・欧州の14リージョンだけで、アジア太平洋のリージョンは1つも含まれていません。つまり GitHub-hosted runner からの通信は、必ず国外から出ていくことになります。
広告配信では、配信先や計測の対象を地域で制限することがあります。テストが接続しているエンドポイントに同様の制限があれば、国外からのアクセスは弾かれます。
- 確証より、検証を優先した
送信元が国外であることは確かめられました。ただ、接続先が実際に地域で弾いているのかどうかまではこちらからは確認できません。とはいえ、既存の CI と新しいフローの差分を説明できる仮説としては、これが最も有力でした。トレーナーの方に相談したところ、そうした制限はあるという話も聞けました。
そこで、確証を得ることに時間をかけるより、この仮説に沿った構成を実際に試したほうが早いと判断しました。仮説が正しければテストは通りますし、通らなければ別の原因を探せばよいからです。
E2E テストだけを CodeBuild で動かす
接続先のエンドポイント側の制限は、緩和する対象ではありません。とすれば、実行環境の側で解く必要があります。
ただし、すべての Job で解く必要はありません。lint、build、ユニットテストは外部のエンドポイントへ接続しないため、GitHub-hosted runner でも問題なく動きます。適切な環境からの実行が必要なのは、E2E テストだけです。
ここで、移行前の CI の構成を思い返しました。既存のフローはすべて CodeBuild の上に組まれていたものです。E2E テストが問題なく動く環境は、すでにあったわけです。
GitHub Actions から E2E テストを切り出しつつ、既存の環境を活かす。
方針が決まってから調べたところ、AWS の公式ドキュメントに、まさにその構成にあたる CodeBuild-hosted GitHub Actions runner の説明が見つかりました。特定の Job の runner として CodeBuild を使える機能で、GitHub の分類では self-hosted runner の一種にあたります。
self-hosted runner を自前で用意する案も検討しました。自社のプライベートクラウドへ載せる、あるいは EC2 上に立てる、といった選択肢です。見送った理由は稼働時間です。CI の runner に求められるのは、Pull Request が作られたときに動くことだけで、常時ホットスタンバイである必要はありません。使っていない時間にも費用が発生するため、採用しませんでした。一方、CodeBuild-hosted runner は Job の要求があったときだけ起動します。
| 検討案 | 課題 | 判断 |
| GitHub-hosted runner のみ | E2E の接続先に対して国外 IP からでは期待どおりに動作しない | 不採用 |
| self-hosted runner を自前で用意 (プライベートクラウド / EC2) |
常時稼働が前提になるが、その必要がない | 見送り |
| CodeBuild-hosted runner | AWS 側の設定とコストが必要 | 採用 |
ハイブリッド構成の実装
変更したのは、E2E テストを実行する Job の runs-on の部分だけです。
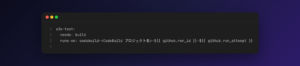
CodeBuild-hosted runner は、codebuild- から始まる決められた形式のラベルで指定します。プロジェクト名に実行 ID と試行回数を続けると、その実行専用の runner が起動します。
lint と build、そして結果のコメントは GitHub-hosted runner のままです。E2E テストだけが CodeBuild 上で動きます。実行環境は2つに分かれますが、各 Job の状態と結果はすべて Pull Request の画面に並ぶため、確認する場所は1箇所で済みます。
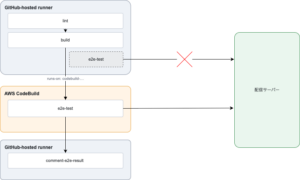
仮説と整合する結果になった
CodeBuild-hosted runner の上で E2E テストを動かすと、17ケースの失敗は解消しました。確証を取らずに進めた「送信元 IP による制限」という見立てと、矛盾しない結果です。実行環境を移すと IP 以外の条件も同時に変わるため、これだけで原因を1つに特定できたわけではありませんが、仮説に沿った対処で問題が解けたことは確かです。
同時に、リトライで膨らんでいた所要時間も元に戻りました。遅さの原因が処理性能ではなく失敗の繰り返しにあったことも、これで確かめられました。
Terraform による IaC 化
runner に必要な AWS リソースを Terraform で定義し、apply の経路を GitHub Actions のみに絞りました。
最初からコードで定義する
ハイブリッド構成にするには、AWS 側にも新しくリソースを用意する必要があります。CodeBuild-hosted runner を動かすための CodeBuild プロジェクト、webhook、IAM ロール、そして CloudWatch Logs のロググループです。
ここで気になったのは、既存の CI が載っていた CodeBuild のビルドプロジェクトがコードとして管理されていなかったことです。定義が残っていないため、同じ構成を作り直せる保証がなく、変更の履歴も追えません。
そこで、今回追加する分は最初から Terraform で定義することにしました。インフラのコード化は、チームでもいま力を入れて進めているところでした。
IAM ロールの権限はログの書き込みだけに絞り、webhook にも条件を付けています。Pull Request CI という特定のワークフローからの要求でなければ、runner は立ち上がりません。
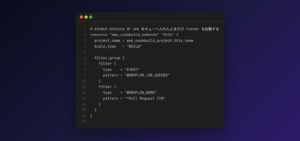
なおチームの他のリポジトリでは以前から Terraform が運用されており、モジュールの分け方や抽象化の粒度に既存の基準があります。今回足す部分も、その基準に合わせて書きました。定義そのものは生成 AI を使えばすぐに出てきますが、出てきたものが既存の基準に沿っているか、そして AWS のリソースとして正しいかを確かめるには時間がかかりました。書いている時間より、レビューに費やした時間のほうが長かったと思います。
ローカルから操作しない
init / plan / apply はローカル端末から実行せず、GitHub Actions 経由のみに統一しました。これもチームで進めている方針に沿ったものです。認証情報をローカルへ配布せずに済み、誰が・いつ・何を apply したかが Pull Request のやり取りとして残ります。
ただし、この方針には手間が伴います。plan の実行と結果のコメント、apply の実行、変更内容の検証。それぞれをワークフローとして用意する必要があり、Terraform 関連のワークフローは最終的に6つになりました。
E2E テストの並列化
E2E テストを Mocha の並列実行機能で4並列にし、単体で約18分かかっていたものを6分20秒にしました。
なぜ並列化に取り組んだか
先述の通り、CI 全体の19分弱のうち約18分を E2E テストが占めていました。CI を速くしたければ、手をつける先は E2E テスト以外にありません。
依頼されていたのは移行までで、実行時間の短縮は含まれていませんでした。それでも、Pull Request を出してから結果が出るまで19分待つのは、素直に長いと感じていました。ここは手を入れる価値があると考えました。
仮説を立てる
きっかけは、はっきりしない違和感でした。E2E テストは遅い。それなのに、CodeBuild の CPU 使用率は低いままです。割り当てられたリソースを使い切れていません。
そこで、テストが実際にどう動いているのかを確認しました。分かったのは、すべてのテストが直列で実行されていることです。
であれば、並列化できるのではないか。これが立てた仮説です。
ただし、いくらでも並列数を増やせばよいという話ではありません。並列数を増やせば、runner 上で同時に動くプロセスが増え、CPU とメモリの要求も大きくなります。CodeBuild は実行時間に応じて課金されるため、速さとコストのどちらを取るかというトレードオフが必ず出てきます。
そこで、提案する前に手元で計測することにしました。
検証する
並列数を変えながら、所要時間とリソース使用量を手元の Mac で測りました。
CodeBuild のインスタンスとは CPU のコア数もメモリも異なるため、ここで確かめたいのは絶対値ではなく、並列数を増やしたときに何が起きるかという傾向です。
| 並列数 | 所要時間 | 速度比 | 並列効率 | 最大 RSS |
| 1(直列) | 806秒 | 1.00倍 | — | 約 5.8 GB |
| 2 | 409秒 | 1.97倍 | 98.5% | 約 7.3 GB |
| 4 | 218.3秒 | 3.69倍 | 92.3% | 約 10.0 GB |
| 6 | 177秒 | 4.55倍 | 75.9% | 約 12.6 GB |
4並列の値は3回連続で成功した実行の平均、それ以外は1回の測定です。いずれも既存のテストコードのまま並列化した場合の値であり、固定秒待機には手を入れていません。
この傾向をもとに、最終的に4並列を選びました。6並列がもっとも速いことは確かですが、並列効率が 75.9% まで落ち、メモリ使用量は約 12.6 GB まで増えます。速さの伸びが鈍る一方で、リソースの要求だけが大きくなる領域に入っています。
実行先である CodeBuild の BUILD_GENERAL1_LARGE は 8 vCPU / 16 GiB です。Mac での測定値をそのまま当てはめるなら、4並列の約 10 GB は収まりますが、6並列の約 12.6 GB は上限に近く、余裕がありません。その手前で止めるのが妥当だと判断しました。
分割の仕組みは自前で用意せず、テストフレームワークである Mocha の並列実行機能をそのまま使用しました。
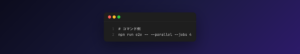
並列数を渡すと、Mocha がテストファイルを複数のワーカープロセスへ分配し、結果の集約まで行ってくれます。
心配していたのは、テストケースの間に依存がある場合です。並列実行では実行順序が保証されないため、暗黙に順序へ依存しているテストがあれば失敗します。しかし既存のテストコードがケースごとに分離されていたため、Mocha へ並列数を渡すだけで期待どおりに動きました。
結果
依頼された目的は達成し、あわせて実行時間を 51.3%、実行コストを 63.2% 削減しました。時間の短縮は並列化のみによるもので、コストの削減は移行と並列化の両方によるものです。
依頼された目的の達成:Job ごとに結果が見えるようになった
改善前は CodeBuild のビルドが1項目だけだった Pull Request の画面に、改善後は Job ごとの結果が並びます。どこで失敗したのかがその場で分かり、ログもそれぞれの Job から直接たどれます。
あわせて、CI の結果を Pull Request へコメントする Job も用意しました。E2E テストの結果、CodeBuild と GitHub Actions のビルド詳細へのリンク、本番用ビルドの所要時間、そして生成されたバンドルのサイズがひとつの表にまとまります。
実行時間:51.3% 短縮
| 改善前 | 改善後 | |
| CI 全体の実行時間 | 1,132秒 | 551秒 |
改善後の内訳は次のとおりです。
| Job | 所要時間 |
| lint | 37秒 |
| build | 1分35秒 |
| e2e-test | 6分20秒 |
| comment-e2e-result | 5秒 |
内訳を足すと全体の値より少し小さくなりますが、その差は Job のキュー待ちや runner の起動にかかる時間です。
短縮できた分のほぼすべてが E2E テストによるものです。先ほど触れた約18分が、6分20秒まで縮んでいます。lint と build の所要時間は、移行の前後でほとんど変わっていません。GitHub Actions への移行そのものは、実行時間には寄与していません。
測定は、同一の Pull Request に対する CI の実行結果を、改善の前後で比べたものです。複数回の実行を平均した値ではありません。
実行コスト:63.2% 削減
| 改善前 | 改善後 | |
| 1 実行あたりのコスト | US$0.38 | US$0.14 |
CodeBuild は実行時間に対して課金されます。今回使っている Linux の BUILD_GENERAL1_LARGE の単価は、1分あたり US$0.02 で、課金は分単位の切り上げです。
移行前は、すべての処理が CodeBuild の上で動いていました。約19分かかっていたため、1回あたり US$0.38 になります。移行後に CodeBuild で動くのは e2e-test の約7分だけで、US$0.14 に収まります。残りの Job は GitHub-hosted runner へ移りました。
なお、この計算では、GitHub Actions のコストは組織が保有する無料枠の範囲で完結するとみなしています。
まとめ
良かったこと
判断の根拠を持って提案できたこと
はじめに挙げた目標については、手応えがありました。CodeBuild-hosted runner を選んだ理由、自前の self-hosted runner を見送った理由、並列数を4に決めた理由。いずれも自分で調べ、測った結果をもとに説明できます。E2E テストの並列化は当初のスコープ外でしたが、検証した数字を示して提案し、実際の CI へ導入することができました。
慣れていない領域をキャッチアップできたこと
先に触れた通り、GitHub Actions には慣れていた一方、Terraform と AWS は少し触ったことがある程度、アドテクという領域はまったくの未経験でした。公式ドキュメントや技術ブログにも助けられましたが、それ以上に大きかったのは、分からないことをその場でチームに聞ける環境でした。
今後の改善余地
今回のスコープは、Pull Request 時の CI フロー改善です。それは達成することができました。そのうえで、取り組みを通じて次の改善余地が見えています。
E2E テストの実行時間のさらなる短縮
今回導入した並列化は、待ち時間そのものを減らすのではなく、並べて隠す対処です。テストコードの固定秒待機を条件待ちなどへ置き換えられれば、実行時間とコストの両方をさらに下げられます。
分割の仕方にも余地があります。LPT(Longest Processing Time first)方式は、実行時間の長いテストファイルから順にワーカーへ割り当てる方法です。これを採れば各プロセスの終了時刻が揃い、全体の完了を早められると考えています。最適な並列数も、テストの構成や実行環境が変われば変わるため、継続的な見直しが要ります。
CD 部分の改善
今回扱ったのは Pull Request 時の CI までで、デプロイ側には手を入れていません。ただ、今回作った CodeBuild-hosted runner と Terraform の構成は、そのままデプロイ側にも応用できるはずです。同じやり方を広げていければ、CI と CD を通して見通しのよい状態にできると考えています。
最後に
1ヶ月を振り返って最も印象に残っているのは、チームの皆さんとのコミュニケーションです。慣れていない領域について何を聞いても、いつも丁寧に答えていただきました。遠慮なく質問できる空気があったからこそ、迷いすぎずに手を動かし続けられたのだと思います。
エンジニアとして働くイメージの解像度は、参加前より確かに上がりました。そして何より、楽しいと思えました。
ProFit-X チームの皆さま、そしてこの機会をいただいた人事の皆さま、本当にありがとうございました!