

こんにちは。
AI 事業本部 AI クリエイティブカンパニー BPO 事業部のエンジニアの佐藤 (@Rintarooo) です。
最近はもっぱらアナログのレコードを集めるのにハマってます。気が付けば回転するのをただボッーーと眺めてる時間が増えました。
目次
- はじめに
- 想定する読者
- 課題:オートスケールとデプロイ不要のプロンプト更新を保ったまま、Langfuse の停止に備える
- プロンプトをオブジェクトストレージにミラーする
- オブジェクトストレージの構成で工夫したこと
- おわりに
はじめに
前回の記事(Mastra をバックエンド + AI エージェントサーバーとして本番運用してみた)で、LLM アプリケーションのプロンプトを GitHub 上のコードから切り離し、Langfuse に移したことについて触れました。Langfuse は LLM の可観測性やプロンプト管理の機能を持つ OSS で、私たちはセルフホストして運用しています。
そうした中、ダウンタイムを伴う Langfuse のアップグレード作業を行うことになりました。私たちは現在、LLM を使ったチャットをコア機能とするサービスを提供しています。このサービスは実行時に Langfuse からプロンプトを取得するため、Langfuse が止まるとチャット機能が使えなくなります。セルフホストの場合、こうしたアップグレード作業や障害で Langfuse が止まっている間も、プロンプトを LLM アプリに配布し続ける方法を、自分たちで用意する必要があります。
本稿執筆時点で、Langfuse の公式ドキュメントの Guaranteed Availability でもプロンプトの可用性を確保する方法は紹介されていますが、アプリをオートスケールさせる環境や、デプロイせずにプロンプトを更新する運用には合わない点がありました。そこで私たちは、公式の方法とは別のアプローチとして、Langfuse のプロンプトをオブジェクトストレージに自動でコピーしておき、Langfuse が止まったときだけそこから取得する構成を取りました。本記事では、公式の方法が合わなかった具体的な事例とあわせて、その詳細を紹介します。
想定する読者
- LLM アプリケーションを開発・運用している方、もしくは今後開発する予定や興味のある方
- Langfuse をセルフホストして運用している方、もしくは導入を検討している方
課題: オートスケールとデプロイ不要のプロンプト更新を保ったまま、Langfuse の停止に備える
Langfuse の停止に備えるにあたり、まず公式の方法を検討しました。公式ドキュメントの Guaranteed Availability では、プロンプトの可用性を確保する方法として次の2つが紹介されています。
- 起動時の pre-fetch: アプリの起動時にプロンプトを取得し、取得できなければ起動を止める
- fallback: プロンプトを取得できなかったときに使うプロンプトを、コード内に持っておく
起動時の pre-fetch が採用できない理由
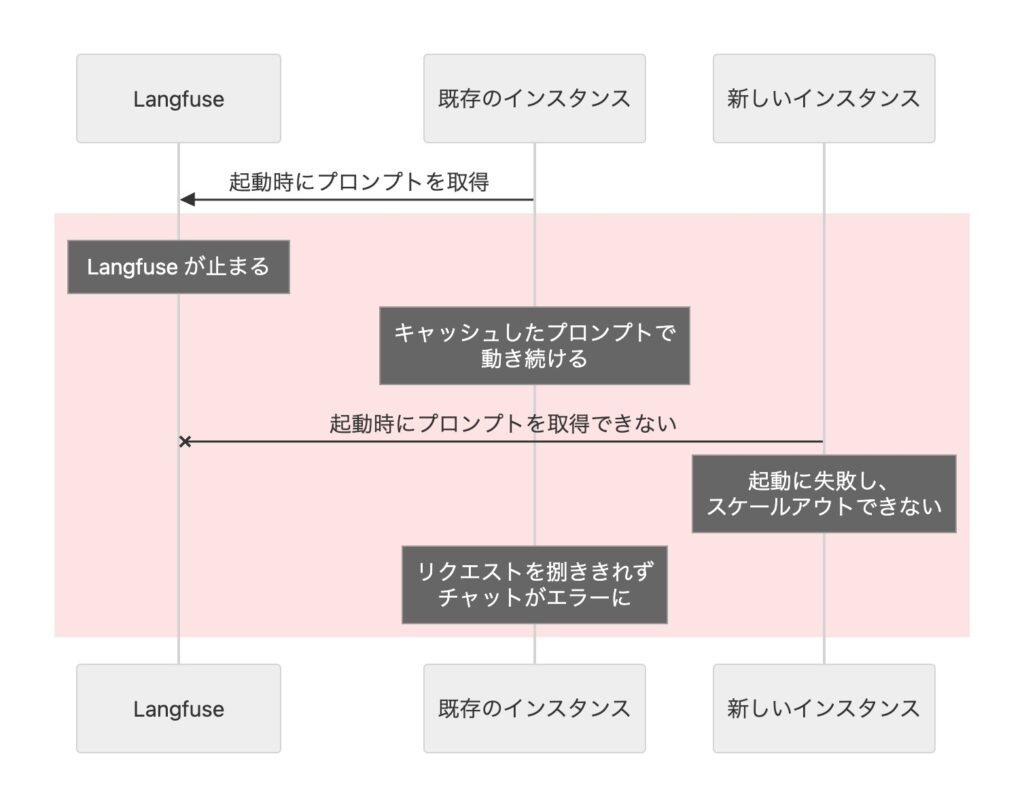
1つ目の起動時の pre-fetch は、起動時にプロンプトを取得できなければアプリのプロセスを終了させる、という方法です。起動後は SDK がインスタンスのメモリ上にキャッシュしたプロンプトを返すので、既に稼働中のインスタンスでは Langfuse が止まってもチャット機能は動き続けます。その代わりに、起動するには Langfuse からプロンプトを取得できることが必須になるため、Langfuse がインスタンス起動の単一障害点になります。
ただし、固定台数の VM のようにプロセスが長時間動き続ける環境なら、アプリが起動するのはデプロイや再起動のときくらいです。Langfuse の復旧を待ってからデプロイするなど、デプロイのタイミングを調整すれば、起動時の失敗は避けられます。
一方、私たちの LLM アプリは Cloud Run 上でステートレスに動いており、リクエスト量に応じてインスタンスがオートスケールします。そのため、Langfuse が止まっている間にリクエストが増えると、新しいインスタンスはプロンプトを取得できずにアプリの起動に失敗し、スケールアウトできません。その結果、既存のインスタンスだけではリクエストを捌ききれなくなり、チャットがエラーになります。つまり、オートスケールする環境では、インスタンス起動の単一障害点である Langfuse が止まると、チャット機能まで使えなくなってしまいます。
fallback をやめた理由
2つ目の fallback は、Langfuse からプロンプトを取得できなかったときに使うプロンプトを、あらかじめコード内に持っておく、という方法です。私たちも当初はこの方法を採用し、Git で管理しているコードの中にプロンプトをハードコードしていました。fallback なら、Langfuse が止まっていてもコード内のプロンプトで応答できるので、オートスケールとも両立します。しかし、運用する中で問題に気づきました。
私たちのサービスでは、ユーザーの入力に応じて LLM が検索ツールを呼び出し、その結果をもとに提案するチャット機能を提供してます。あるとき、ユーザーとの会話やツールの入出力を記録した Langfuse のトレースから、ツールの検索結果にないものを LLM が自身の知識から提案していることに気づきました。いわゆるハルシネーションです。そこで PM が、検索結果にないものは提案しないよう、プロンプトに数行の指示を追加しました。エンジニアが開発・ステージング環境で検証したうえで、本番環境に反映しました。アプリをデプロイせずに済んだので、問題に気づいた当日のうちにユーザーへの影響を止められました。
ところが、コード内の fallback には、修正前のプロンプトが残ったままです。fallback が更新されるのは、次にアプリをデプロイしたときだけだからです。その間に Langfuse が止まると、修正前のプロンプトが使われ、また範囲の外のものを提案してしまいます。fallback は Langfuse が止まったときにしか使われないので、こうした乖離があっても普段は気づけません。
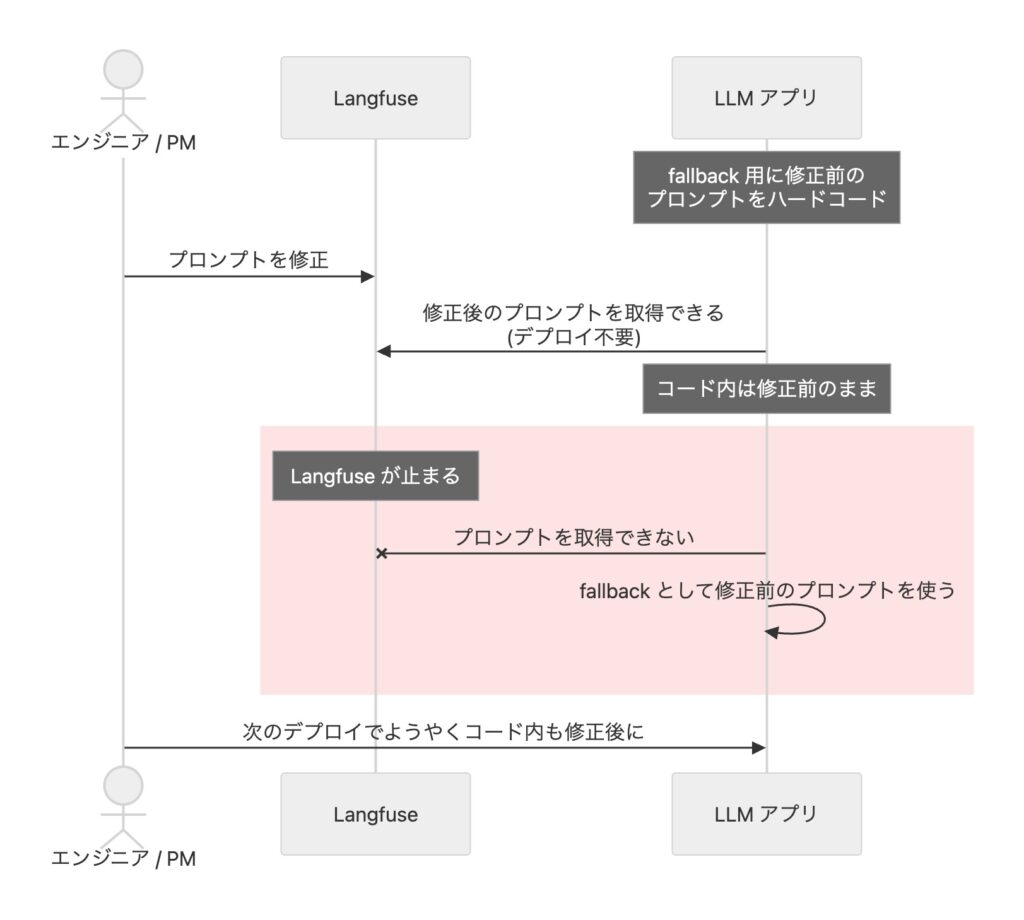
コード内の fallback は、Langfuse 公式の GitHub Integration でリポジトリへ自動で同期することもできます。ただ、アプリに届くのはデプロイのときなので、この乖離は残ります。かといって、プロンプトを直すたびに本番環境へデプロイしていては、ほかのコードの変更とあわせたリリースの手順を踏むことになり、プロンプトのデリバリーがアプリのデプロイサイクルに縛られ、遅くなってしまいます。
私たちに必要だったのは、Langfuse と常に同じプロンプトを、デプロイを待たずに、Langfuse が止まってもアプリが読める場所に置くことでした。
プロンプトをオブジェクトストレージにミラーする
そこで私たちは、Langfuse でプロンプトを更新するたびに、その内容をオブジェクトストレージに自動でコピーすることにしました。こうすれば、ストレージには、デプロイを待たずに Langfuse と同じプロンプトが揃います。Langfuse の更新に追従し続けるコピーなので、本記事ではこれを「ミラー」と呼びます。
ミラーとプロンプトの取得の全体像は次のとおりです。
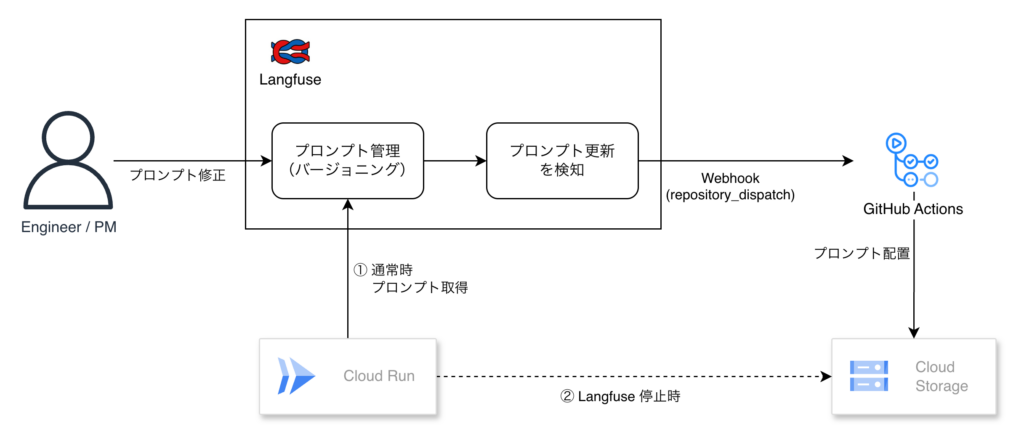
ミラーは、Langfuse の Automations と GitHub Actions を組み合わせて実現しています。
- エンジニアや PM が、Langfuse でプロンプトの新しいバージョンを作成する、もしくはラベルを付け替える
- それをトリガーに GitHub Actions のワークフローが起動し、各環境で使うラベルのプロンプトを Langfuse から取得する
- 取得したプロンプトを、環境ごとにオブジェクトストレージへ配置する
手順 1、2 のように、プロンプトの変更をトリガーに GitHub Actions のワークフローを起動する方法は、Langfuse 公式の GitHub Integration for Langfuse Prompts でも紹介されています。
こうしてミラーしたプロンプトを、LLM アプリは Langfuse が止まったときだけ読みます。通常時は、これまでどおり Langfuse から取得します。
プロンプトを編集するのは Langfuse だけで、オブジェクトストレージの中身を手で書き換えることはありません。そのため、Langfuse を Single Source of Truth に保ったまま、Langfuse が止まっても最新のプロンプトでチャット機能を提供し続けられます。
ミラー先にオブジェクトストレージを選んだ理由
ミラーしたプロンプトの置き場所は、新しく起動したインスタンスを含め、すべてのインスタンスから読める場所である必要があります。その候補としては、オブジェクトストレージのほかに、Redis のようなインメモリストアも考えられます。
インメモリストアは低レイテンシで読み出せるのが利点ですが、私たちの用途ではその速さを活かす場面がほとんどありません。ミラーしたプロンプトを読むのは、Langfuse が止まっていて、SDK のキャッシュもないときだけです。また、LLM の応答には数秒かかるため、ストレージからの読み込みがボトルネックになることはありません。
一方で、インメモリストアはサーバーを常時稼働させる必要があるため、使っていない時間もコストがかかり続けます。オブジェクトストレージなら、コストは保存しているデータ量とリクエスト数の分だけです。プロンプトは小さなテキストデータであり、書き込むのはプロンプトを更新したとき、読むのは Langfuse が止まったときだけなので、インメモリストアと比べてコストを大きく抑えられます。また、オブジェクトのバージョニングを有効にしておけば、ミラーしたプロンプトの履歴も残せます。
Langfuse から優先して取得する理由
図で示したように、LLM アプリは通常時は Langfuse から取得し、取得できなかったときだけオブジェクトストレージを読みます。ここでは、なぜこの取得の優先順位にしたのかを説明します。
常にストレージから読む構成にしなかったのは、使われるプロンプトを常に Langfuse と一致させるためです。常にストレージから読むと、ミラーが反映されるまでのタイムラグの間は、古いプロンプトが使われます。さらに、ミラーに失敗すると、気づかないまま古いプロンプトで動き続けてしまいます。一方、通常時に Langfuse から読んでいれば、ミラーに失敗しても、影響が出るのは Langfuse が止まったときだけです。
Langfuse から直接取得すると、リクエストのたびに Langfuse に問い合わせることになるのでは、と思うかもしれません。Langfuse の SDK には、取得したプロンプトをインスタンスのメモリに一定時間保持するキャッシュ機能があり、私たちは環境ごとに設定を使い分けています。
- 本番環境以外: Langfuse 公式の Caching of Prompts in Client SDKs の推奨に従って、キャッシュを無効にしています。Langfuse で編集したプロンプトがすぐに反映されるので、編集と動作確認を繰り返すプロンプトチューニングを素早く回せます。
- 本番環境: キャッシュを有効にしているため、リクエストのたびに Langfuse に問い合わせることはありません。セルフホストしている Langfuse への負荷や、プロンプト取得のレイテンシを抑えられます。
オブジェクトストレージのプロンプトは、Langfuse の更新に合わせて自動で入れ替わります。そのため、fallback のように修正前のプロンプトが残り続けることはなく、当初コード内にハードコードしていた fallback は削除できました。
オブジェクトストレージの構成で工夫したこと
Langfuse が止まってオブジェクトストレージから読むときも、アプリは通常時と同じプロンプトと LLM パラメータで動く必要があります。ここでは、そのためにストレージの構成で工夫した点を2つ紹介します。
環境ごとのバケットに、その環境で使うバージョンを置く
Langfuse では、プロンプトのバージョンにラベルを付けて、環境ごとに使うバージョンを指定しています。標準で用意されているラベルは latest と production だけなので、ステージング環境向けには staging ラベルを独自に追加しています。
| 環境 | 使うラベル |
|---|---|
| 開発環境 | latest |
| ステージング環境 | staging(なければ production) |
| 本番環境 | production |
1つのラベルだけをミラーする素朴な方法では、この使い分けが崩れます。たとえば latest ラベルだけをミラーすると、Langfuse が止まったときに、開発環境で編集中のプロンプトが本番環境で使われてしまいます。
そこで、環境ごとにバケットを分け、それぞれの環境で使うバージョンを配置しています。どのバージョンを置くかは、ミラーするときに決めています。たとえばステージング環境では、staging ラベルがなければ production ラベルのバージョンを置きます。そのため、アプリ側はこのような判定ロジックを入れずに、自身の環境のバケットを読むだけで済みます。
こうして、Langfuse が止まっても、各環境は通常時と同じバージョンのプロンプトで動き続けます。
プロンプト本文と LLM パラメータを一緒に置く
各バケットには、プロンプトごとに以下の 2 つのファイルを置いています。
{promptId}.txt: プロンプト本文{promptId}.config.json: Temperature や Thinking Budget などの LLM パラメータ
Langfuse では、本文とパラメータが同じバージョンとして管理されています。本文だけをミラーしてパラメータをコードに残すと、「本文は新しいのにパラメータは古い」という乖離が起きます。そのため、両方をまとめて配布しています。
おわりに
本記事では、セルフホストの Langfuse が止まってもプロンプトを LLM アプリに配布し続けるための構成を、実際の運用で直面した事例とあわせて紹介しました。Langfuse 公式が紹介している方法は、起動時の pre-fetch がオートスケールする環境に、fallback がデプロイせずにプロンプトを更新する運用に、それぞれ合いませんでした。そこで私たちは、公式の方法とは別のアプローチとして、Langfuse のプロンプトをオブジェクトストレージにミラーし、Langfuse が止まったときだけそこから取得するようにしました。
これにより、ダウンタイムを伴う Langfuse のアップグレード作業の間も、メンテナンス時間を設けずに、最新のプロンプトでチャット機能を提供し続けられました。
なお、私たちが導入した当時はクラウド版が国外リージョンのみだったことなどからセルフホストを選びましたが、本稿執筆時点では日本リージョンでの提供も始まっています。これから導入する方は、要件や運用コストを踏まえて選ぶと良いかと思います。
本記事の内容が、Langfuse に限らず、プロンプトをコードから切り離して管理している LLM アプリの可用性を検討している方の参考になれば幸いです。